
Cairn-深度拆解-状态空间搜索与Decide-Execute
Cairn 与面向目标的状态空间搜索
本文以本地克隆的 oritera/Cairn(main 分支,提交 8e7e0ea,2026-09-07)为对象,逐文件阅读源码,对照仓库内的 docs/specs/*.md 协议文档与作者复盘,并在本机运行测试套件验证。论述重点为两项:其一,该系统如何把渗透测试重述为面向目标的状态空间搜索;其二,仅由决定与执行两类活动构成的极简循环,其运行条件与代价为何。
GitHub - oritera/Cairn: Cairn is a general-purpose AI state-space search engine, validated first on autonomous penetration testing. Sometimes misspelled as Carin. · GitHub
标注约定。 依照本专题的规则,文中区分三类陈述,以免将作者的声明与本文的推断混用:
标记
含义
原作自述
作者在 README.md、docs/specs/*.md 或复盘中明确写出
源码推得
作者未直接说明,但实现可逐项对应,由本文阅读 ...
LLM新技术中的CS原型(四)ARTEX:双图架构解决长任务幻觉问题
LLM新技术中的CS原型(四)ARTEX:双图架构解决长任务幻觉问题
主作者:陈劲铧
本文基于 ARTEX 当前源码、本地深度拆解文档和仓库既有截图编写。实验仅限本地页面与源码测试,不连接线上 Demo,不执行真实目标探测。ARTEX 官方免责声明禁止将其用于线上系统、生产环境或未经授权的目标。
参考资料
官方仓库:GitHub - mhtsec/ARTEX
Demo:ARTEX — 自主渗透测试控制台
深度拆解:D:/ARTEX/ARTEX/深度拆解/01-系统架构与核心机制.md、02-数据模型与执行链路.md
本地源码快照:D:/ARTEX/ARTEX,当前阅读提交 b55ceb1fdd84a813d77de09a06af83d323a81f85
1 项目介绍
1.1 ARTEX 要解决什么问题
普通 Agent 往往把目标、工具和历史消息交给一个模型,让它连续调用工具,最后输出一段总结。任务一长,就容易出现:
模型忘记目标,重复探测或偏离范围;
前置事实尚未出现,后续步骤已经被提前执行;
一个 Worker 的中间观察没有写入公共状态,其他 Worker 只能重复劳动 ...
LLM新技术中的CS原型(三)MemGPT:将LLMs视为操作系统
LLM新技术中的CS原型(三)MemGPT:将 LLMs 视为操作系统
参考图片:
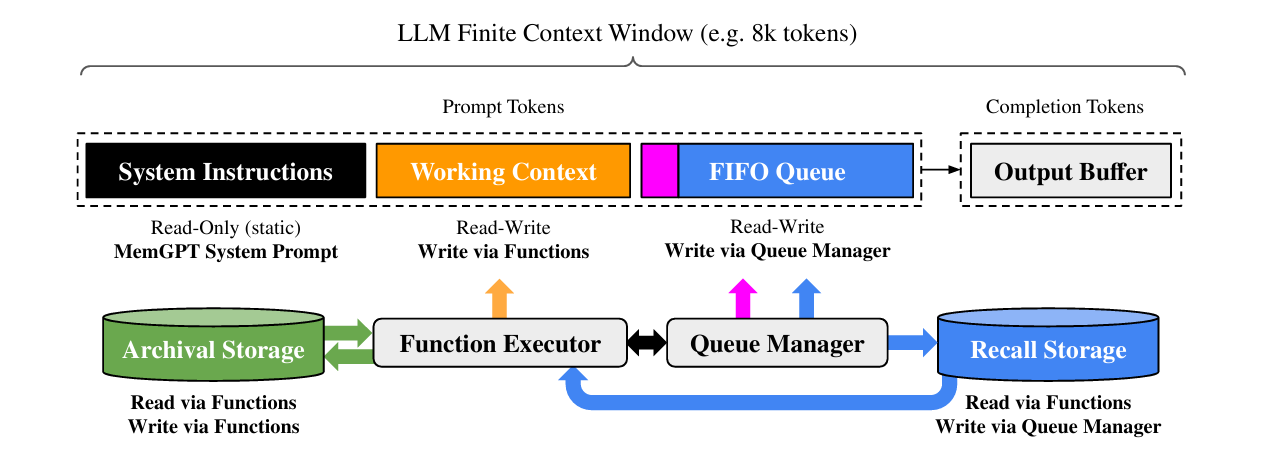
图:MemGPT 论文中的系统结构。有限上下文被划分为系统指令、工作上下文和 FIFO 队列;归档存储与召回存储位于上下文窗口之外。
官方链接:MemGPT Research
GitHub 链接:letta-ai/letta
参考链接:
论文:[2310.08560] MemGPT: Towards LLMs as Operating Systems
论文 HTML 版:MemGPT: Towards LLMs as Operating Systems
当前活跃实现:letta-ai/letta-code
中文解读:MemGPT:将 LLMs 视为操作系统——以达无限 Context
版本说明: 本文主要分析 arXiv 2310.08560v2,该版本首次提交于 2023 年 10 月,最后修订于 2024 年 2 月。MemGPT 后来更名为 Letta;截至本文编写时,letta-ai/letta 已成为历史入口,活跃代码位于 letta-ai/letta-code。除第 5 节外,文 ...
LLM新技术中的CS原型(二)vLLM:KVCache的虚拟内存分页
LLM新技术中的CS原型(二)vLLM:KV Cache 的虚拟内存分页
官方链接:vLLM
github链接:vllm-project/vllm: A high-throughput and memory-efficient inference and serving engine for LLMs
参考链接:
强相关论文:
[2309.06180] Efficient Memory Management for Large Language Model Serving with PagedAttention
知乎优质博客:vLLM不知如何开始?看这篇:vLLM框架快速入门引导
https://zhuanlan.zhihu.com/p/1984742841528902530
被咕咕了。未完待续。
LLM新技术中的CS原型(一)Openviking:上下文像文件系统一样组织
LLM新技术中的CS原型(一)OpenViking:上下文像文件系统一样组织
主作者:陈劲铧
参考图片:
官方链接:OpenViking - The Context Database for AI Agents
github链接:volcengine/OpenViking: Self-evolving Context Database for AI Agents. Unify Agent Memory, Knowledge RAG and Skills.
参考链接:
个人博客:OpenViking_记忆库理论与工具分析及个人体验(初期探索) | CJH’s blog
强相关论文:
[2605.29640] VikingMem: A Memory Base Management System for Stateful LLM-based Applications
[2609.11390] VikingRAG: Accurate and Token-efficient Retrieval-augmented Generation over Structured Documents
[ ...
LLM新技术中的CS原型(零)
LLM新技术中的CS原型(零):专题介绍
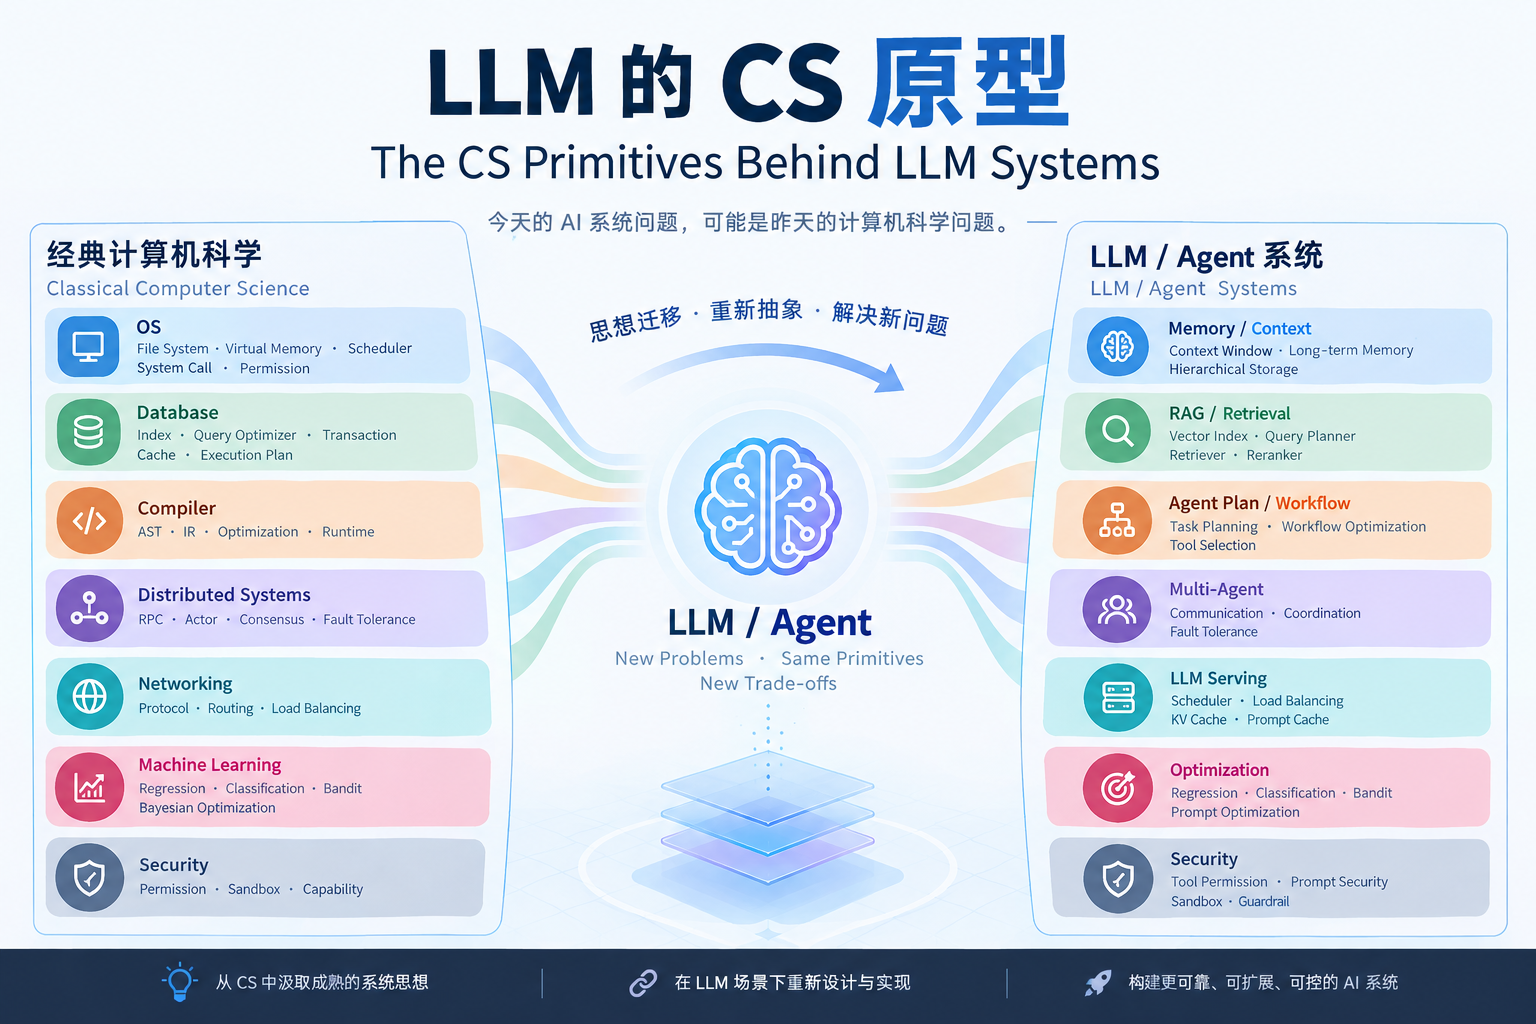
副标题:今天的 AI 系统问题,可能是昨天的计算机科学问题。
参考图:
0 前言
该专题由陈劲铧/杨万宏共同策划编写。该作品使用了AI工具编排与润色,但核心内容与理念都由两人共同分析总结。如对作品内容有疑问,联系方式如下:
陈劲铧:深圳大学24届计算机技术研究生。
博客:CJH’s blog - CJH’s blog
邮箱:1005741898@qq.com
杨万宏:深圳大学25届计算机技术研究生。
博客:
邮箱:
1 专题介绍
今天的 AI 系统问题,可能是昨天的计算机科学问题。
随着大模型逐渐从一个“生成模型”演变为完整的软件系统,Memory、RAG、Tool Calling、Agent、Workflow、Model Serving、Context Engineering 等问题接踵而来。与此同时,一个非常有意思的现象也越来越明显:当我们拆开这些系统的实现,会不断遇到一些熟悉的身影——文件系统、虚拟内存、数据库索引、查询优化器、编译器、调度器、缓存、RPC、类型系统、分布式一致性、回归、分类、Bandit、贝叶斯优化……这些原本 ...
基准与聚合榜单调研
公开基准与聚合榜单调研
调研日期:2026-08-13
问题:benchlm.ai / llm-stats.com 这类聚合榜单背后的基准数据集有多大?跑一遍需要多少时间和算力?
一句话结论
基准数据集小得出乎意料,算力几乎不是问题——真正的成本来自推理 token 和 agent 多轮,而不是数据量。
更值得注意的是第二点:这些聚合站大多不自己跑基准,而是抓取公开分数,而公开分数之间的可比性远比想象中差。
一、基准到底有多大
主流基准的规模
基准
题量
类型
AIME(单年)
30
数学竞赛,数值答案
CritPt
70
物理推理
Terminal-Bench v2.1
89
终端 agent 任务
𝜏³-Banking
97
工具调用 agent
AA-LCR
100
长上下文推理
ARC-AGI-2(公开评测集)
~120
视觉推理
HumanEval
164
Python 函数补全
GPQA Diamond
198
研究生级四选一
GDPval-AA v2
220
真实工作任务
SciCode
288 子问题
科研代码 ...
TSvsPYTHON在Agent应用开发的优劣势
TypeScript vs Python 在 Agent 应用开发中的优势对比
Python 是当前 Agent 生态绝对主流(LangChain、LlamaIndex、AutoGPT、各类 LLM SDK),但 TypeScript(TS/Node.js) 在 Agent 工程化、生产部署、前端打通、高并发场景有非常明确的优势,同时也存在生态短板。下面聚焦Agent 开发场景,只讲 TS 相对 Python 的优势,顺带点明局限。
TypeScript 在 Agent 开发的核心优势
1. 强类型系统:大型 Agent 项目可维护性显著提升
Agent 代码复杂度来源:多工具调用、多轮上下文、Agent 状态流转、复杂 Prompt 模板、工具入参出参、多 Agent 协作、记忆模块。
TS:静态类型、Interface、Generic、Zod 生态,可对:Agent 状态、工具参数、LLM 结构化输出、记忆数据、消息历史做类型约束。
配合 Zod 做 LLM 输出 Schema 校验:编译期 + 运行期双重校验,减少 LLM 返回非法 JSON 导致 Agent 崩溃。
多 ...
模型测评体系_项目总结与实际测试
模型测评体系
根本测不完,歇逼了。推荐几个可靠的模型测评网站吧QAQ。
llm-stats
LLM Leaderboard & AI Model Benchmarks — Nov 2026 | BenchLM
Arena - 全球领先的AI模型评测平台
TencentDB_技术解析与体验分析
TencentDB-技术解析与体验分析
项目: Tencent/TencentDB-Agent-Memory — 让 Agent 沉淀经验,让人专注创造。
GitHub: https://github.com/Tencent/TencentDB-Agent-Memory
目录
项目定位与核心命题
竞品格局
技术栈与技术实现路线
功能清单
使用方法与工作流程
实现效果与用户价值
可提炼的方法论
局限与风险
可优化项
真实体验与体验分析
附录:关键文件索引与注释
一、项目定位与核心命题
定位
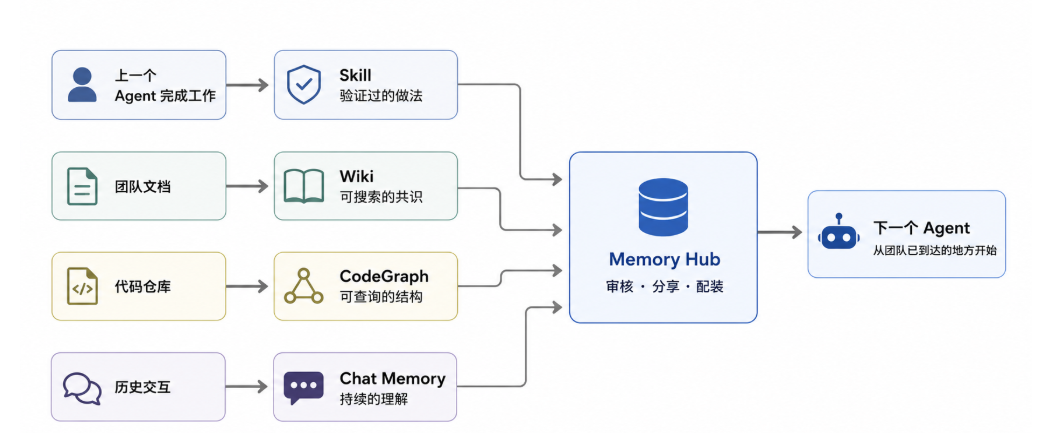
面向 AI Agent 团队的**「记忆 Hub」。核心理念一句话——「让经验沉淀、流动,然后被下一位 Agent 直接继承」**。其价值主张链条:
1已有信息 → 可复用记忆资产 → 更少 Turns → 更少返工 → 更稳定的结果和更高的效率
要解决的实际痛点
换一个 Session,同样的背景(项目、文档、结论)要重新讲一遍
换一个 Agent,文档要从第一页重读
一套已经跑通的做法,下次还要从头摸索一遍
关键约束(如「别重构旧鉴权模块,移动端还在用」)这种高代价上下文,不该靠人每 ...