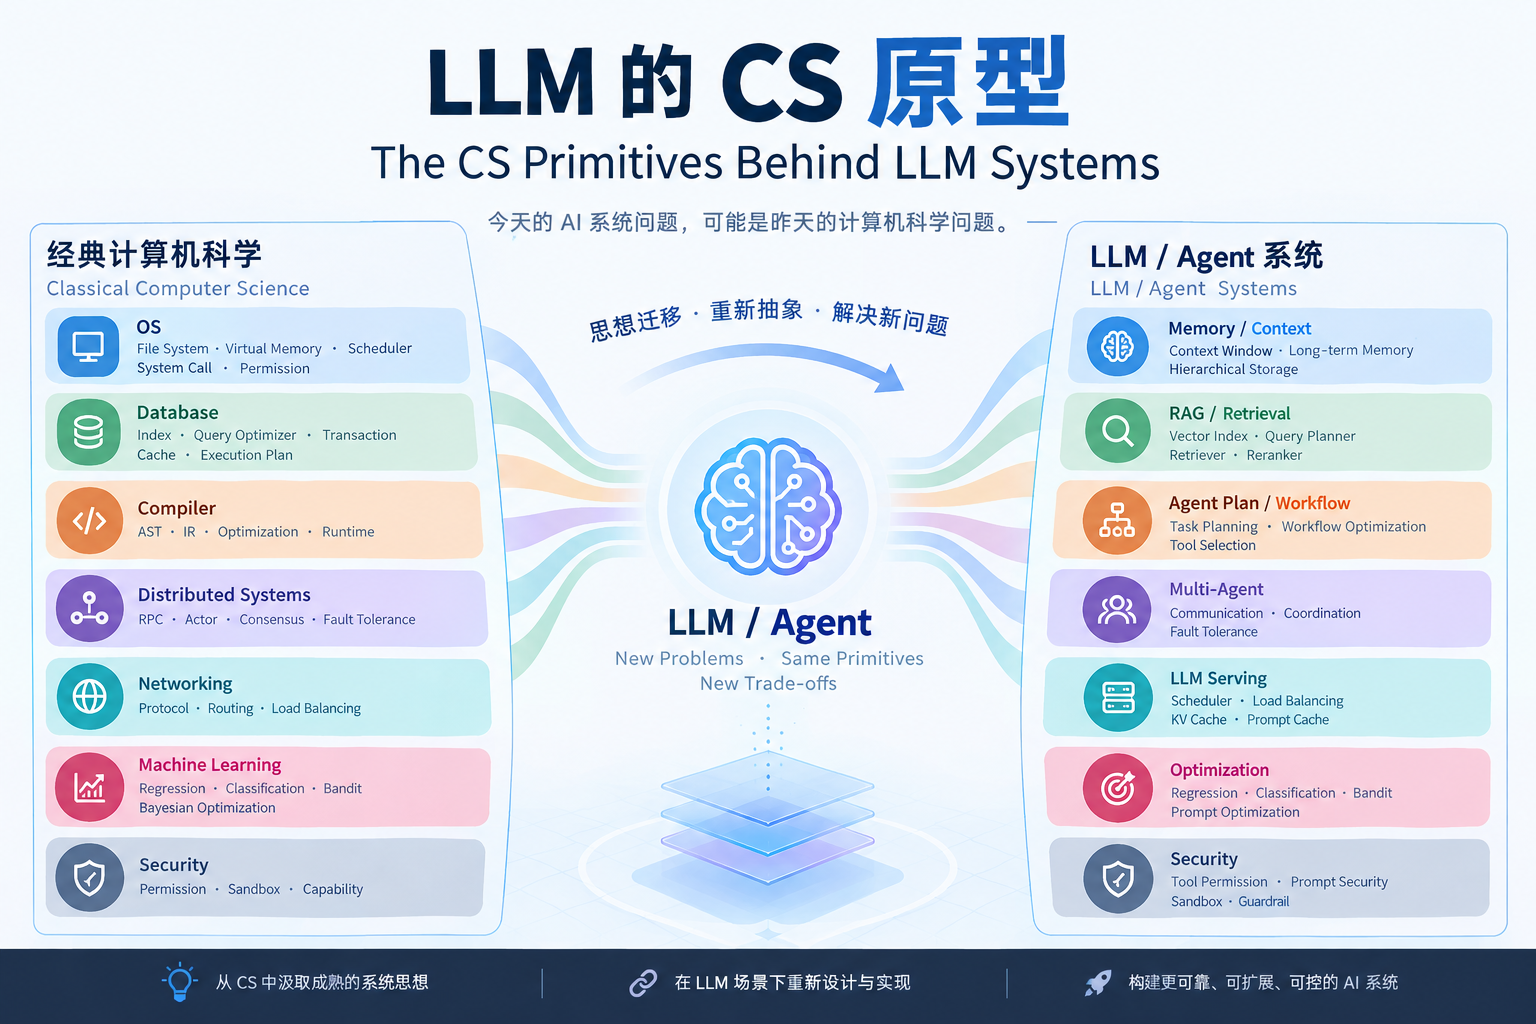
LLM新技术中的CS原型(一)Openviking:上下文像文件系统一样组织
LLM新技术中的CS原型(一)OpenViking:上下文像文件系统一样组织
主作者:陈劲铧
参考图片:
官方链接:OpenViking - The Context Database for AI Agents
参考链接:
- 个人博客:OpenViking_记忆库理论与工具分析及个人体验(初期探索) | CJH’s blog
- 强相关论文:
- CSDN博客:字节开源OpenViking全解(非常详细),Agent上下文存储从入门到精通,收藏这一篇就够了!-CSDN博客
1 项目介绍
OpenViking 是面向 AI Agent 的开源上下文数据库。它用虚拟文件系统组织资源、记忆和技能,让应用按路径浏览、检索相关上下文,并按需读取详细内容。
当 Agent 需要跨会话复用文档和经验时,可以用它集中组织和检索这些上下文。
由于官方文档十分详细,我就只展示一些核心内容和对应的参考链接。重点放在实验,体验与思考中。其中大多数官方已给出及其详细的内容,我仅复制重要内容,方便读者理解OpenViking大致面貌。
1.1 系统概述
1 | ┌────────────────────────────────────────────────────────────────────────────┐ |
1.2 核心模块
| 模块 | 职责 | 关键能力 |
|---|---|---|
| Client | 统一入口 | 提供所有操作接口,委托给 Service 层 |
| Service | 业务逻辑 | FSService、SearchService、SessionService、ResourceService、PackService、DebugService |
| Retrieve | 上下文检索 | 意图分析(IntentAnalyzer)、层级检索(HierarchicalRetriever)、Rerank 精排 |
| Session | 会话管理 | 消息记录、使用追踪、会话压缩、记忆提交 |
| Parse | 上下文提取 | 文档解析(PDF/MD/HTML)、树构建(TreeBuilder)、异步语义生成 |
| Compressor | 记忆压缩 | Schema 驱动的记忆提取、LLM 去重决策 |
| Storage | 存储层 | VikingFS 虚拟文件系统、向量索引、AGFS 集成 |
1.3 Service 层
Service 层将业务逻辑与传输层解耦,便于 HTTP Server 和 CLI 复用:
| Service | 职责 | 主要方法 |
|---|---|---|
| FSService | 文件系统操作 | ls, mkdir, rm, mv, tree, stat, read, abstract, overview, grep, glob |
| SearchService | 语义搜索 | search, find |
| SessionService | 会话管理 | session, sessions, commit, delete |
| ResourceService | 资源导入 | add_resource, add_skill, wait_processed |
| PackService | 导入导出、备份恢复 | export_ovpack, import_ovpack, backup_ovpack, restore_ovpack |
| DebugService | 调试服务 | observer (ObserverService) |
1.4双层存储
OpenViking 采用双层存储架构,实现内容与索引分离:
| 存储层 | 职责 | 内容 |
|---|---|---|
| AGFS | 内容存储 | L0/L1/L2 完整内容、多媒体文件、关联关系 |
| 向量库 | 索引存储 | URI、向量、元数据(不存储文件内容) |
1.5 数据流概览
添加上下文
1 | 输入 → Parser → TreeBuilder → AGFS → SemanticQueue → 向量库 |
- Parser:解析文档,创建文件和目录结构(无 LLM 调用)
- TreeBuilder:移动临时目录到 AGFS,入队语义处理
- SemanticQueue:异步自底向上生成 L0/L1
- 向量库:建立索引用于语义搜索
检索上下文
1 | 查询 → 意图分析 → 层级检索 → Rerank → 结果 |
- 意图分析:分析查询意图,生成 0-5 个类型化查询
- 层级检索:目录级递归搜索,使用优先队列
- Rerank:标量过滤 + 模型重排
- 结果:返回按相关性排序的上下文
会话提交
1 | 消息 → 压缩 → 归档 → 记忆提取 → 存储 |
- 消息:累积对话消息和使用记录
- 压缩:保留最近 N 轮,旧消息归档
- 归档:生成历史片段的 L0/L1
- 记忆提取:根据记忆策略和 MemoryType Schema 从消息中提取记忆
- 存储:写入 AGFS + 向量库
1.6 设计原则
| 原则 | 说明 |
|---|---|
| 存储层纯粹 | 存储层只做 AGFS 操作和基础向量搜索,Rerank 在检索层完成 |
| 三层信息 | L0/L1/L2 实现渐进式详情加载,节省 Token 消耗 |
| 两阶段检索 | 向量搜索召回候选 + Rerank 精排提高准确性 |
| 单一数据源 | 所有内容从 AGFS 读取,向量库仅存储引用和索引 |
2 核心模型
2.1 上下文类型
基于对人类认知模式的简化映射与工程化思考,OpenViking 将上下文抽象为 资源、记忆、能力三种基本类型,每种类型在 Agent 中有不同的用途。
| 类型 | 用途 | 生命周期 | 主动性 |
|---|---|---|---|
| Resource | 知识和规则 | 长期,相对静态 | 用户添加 |
| Memory | Agent 的认知 | 长期,动态更新 | Agent 记录 |
| Skill | 可声明的 agent 能动性配置(AgentDefinedContextType) | 长期,静态 | 用户或系统添加 |
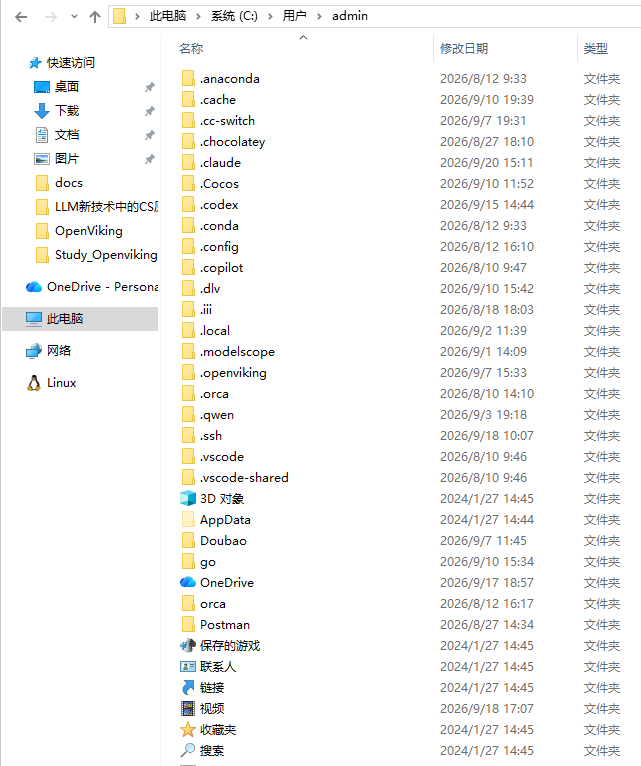
抽象为三种不同基本类型可以通过不同的API和方式进行管理,在我看来资源更像是文件系统中的 办公盘 存储数据为多,记忆更像是 C盘系统盘 存储临时缓存和用户配置,能力更像是配置好的exe程序 只有需要时才会调用。
Resource:资源相对静态和用户主动添加的特性使其非常适合做 团队项目资源。重点倾斜在单个项目多个用户更新或读取等情况。某种情况下有点像Linux多用户读取同一文件的形式,不过换成了 LLM的记忆与规则。
Memory:记忆动态更新的特性使其更加灵活,更贴切原本Agent的记忆系统。好比是操作系统里每个人的个人账号,互相隔离,保留不同agent之间的认知。在下两张对比中,我们可以看到一个常见的windows用户管理系统,其中的.xxx文件就是各类工具的配置/记忆等,在对应的AppData中也存放着相关存档记忆。OpenViking正是借鉴该思路做了虚拟文件系统以进行区分。
Skill:可自己添加的程序型技能。类比可索引到的可启动的脚本程序。
 ](https://www.imagehub.cc/image/image-
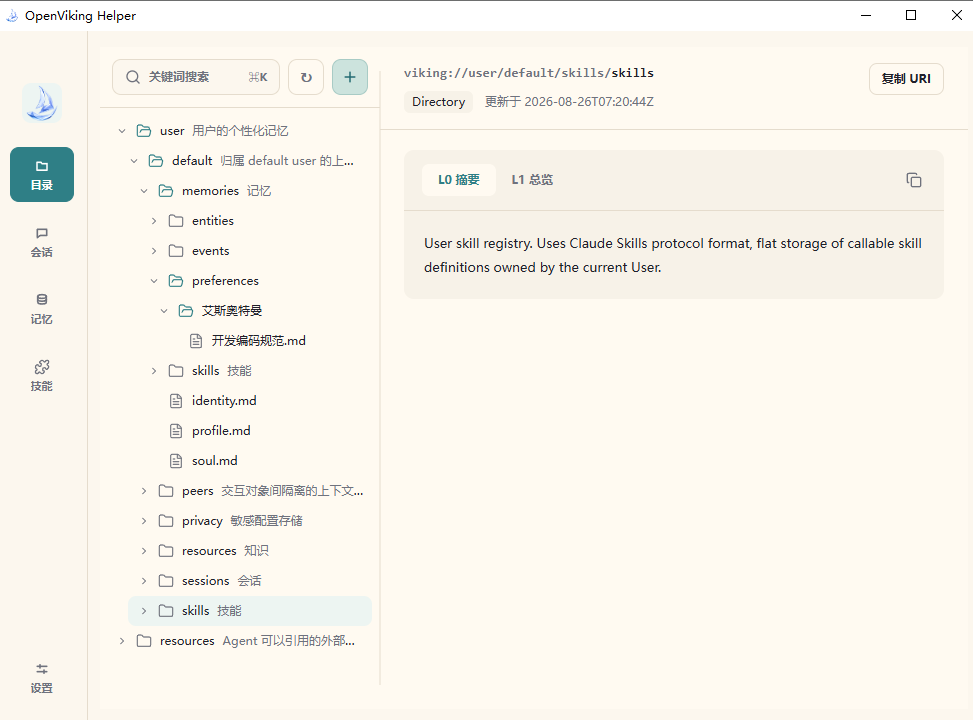
通过OpenViking helper可以直观看到虚拟文件系统中的记忆存储情况。其中对不同文件夹和数据有清楚的分类和排布,加速了文件检索的效率。
2.2 上下文层级(L0/L1/L2)
OpenViking 使用三层信息模型,在检索效率、导航能力和原始内容完整性之间取得平衡。
| 层级 | 名称 | 存储形式 | 默认正文上限 | 用途 |
|---|---|---|---|---|
| L0 | 摘要 | 目录内的 .abstract.md |
256 字符 | 向量检索、快速过滤 |
| L1 | 概览 | 目录内的 .overview.md |
4000 字符 | Rerank、内容导航 |
| L2 | 详情 | 原始文件和子目录 | 无统一上限 | 完整内容、按需加载 |
L0/L1 是目录级语义 sidecar。它们描述一个目录,不是为每个普通文件创建的同名伴生文件。文件摘要会作为输入,聚合到所在目录的 L1 中。
L0 和 L1 通常成对生成,但系统允许只存在其中一个。例如,mkdir() 会先创建 L0:未传入 description 时使用目录名作为默认正文,传入后使用该说明。因此只有 .abstract.md 的目录也是合法状态。读取和向量重建只处理实际存在的层级。
正文上限由 semantic.abstract_max_chars 和 semantic.overview_max_chars 配置;上表是默认值。限制只作用于 Markdown 正文,不会截断 sidecar 元数据。
L0:摘要
L0 是目录内容的最精简表示,用于向量召回和快速相关性判断。
1 | API 认证指南,涵盖 OAuth 2.0、JWT 令牌和 API 密钥的安全访问方式。 |
通过语义 accessor 读取时,只返回可见正文:
1 | abstract = client.abstract(uri="viking://resources/docs/auth") |
L1:概览
L1 提供更完整的目录摘要和导航信息,用于 Rerank 和决定是否继续加载 L2。
1 | # 认证指南 |
1 | overview = client.overview(uri="viking://resources/docs/auth") |
L0 从 L1 正文中提取:取 H1 标题之后、第一个 ## 标题之前的 Brief Description 段落。YAML frontmatter 不参与提取。
L2:详情
L2 是原始文件或解析后的完整内容,只在需要时加载,并保留源格式和结构。
1 | content = client.read(uri="viking://resources/docs/auth/oauth.md") |
目录结构
一个已完成语义处理的目录通常如下:
1 | viking://resources/docs/auth/ |
普通 ls 默认隐藏 .abstract.md 和 .overview.md。它们不一定同时存在;不要依赖“每个目录始终具有两个 sidecar”的假设。
通过L0,L1,L2的方式提高在多文件大文件后期时的检索效率,但我发现其中L0时概括性描述,若换为事实性描述,其检索精度和效率更高。类似相关性树结构。个人人为这种上下文层级的设置还有很多可以优化的空间。
2.3 Viking URI
Viking URI 是 OpenViking 中所有内容的统一资源标识符。
格式
1 | viking://{scope}/{path} |
- scheme: 始终为
viking - scope: 顶级命名空间(
resources、user、agent;temp、queue和upload为内部作用域) - path: 作用域内的资源路径
作用域
| 作用域 | 说明 | 生命周期 | 可见性 |
|---|---|---|---|
| resources | 独立资源/客观知识 | 长期 | account 全局 |
| user | 用户级数据,包括 session | 长期 / 会话生命周期 | 当前用户 |
| agent | agent 能力与配置(技能、端点、工具、支付等) | 长期 | account 全局 |
| queue | 处理队列 | 临时 | 内部 |
| temp | 临时文件 | 解析期间 | 内部 |
| upload | 临时上传文件 | 临时 | 内部 |
公开 API 和 CLI 的文件系统/内容操作接受公开作用域 resources、user 和 agent, 以及根 URI viking://。session 保留为 user session 路径的向后兼容别名; 新 session 数据位于 viking://user/{user_id}/sessions。 temp、queue 和 upload 是内部实现作用域,不能通过公开 API 的 URI 参数直接访问。
这个是最明显的借鉴文件系统方式,使得原本的记忆库可视化可索引可目录化。且极大的便利了文件的分门别类。在此基础上我们搭建了公司的OpenViking+对应gateway中转网关,通过一个OpenViking,不同文件目录管理公司组里的项目记忆,有效节约了同项目跨团队的Agent记忆学习消耗。
3 实际表现
3.1 官方实验截图
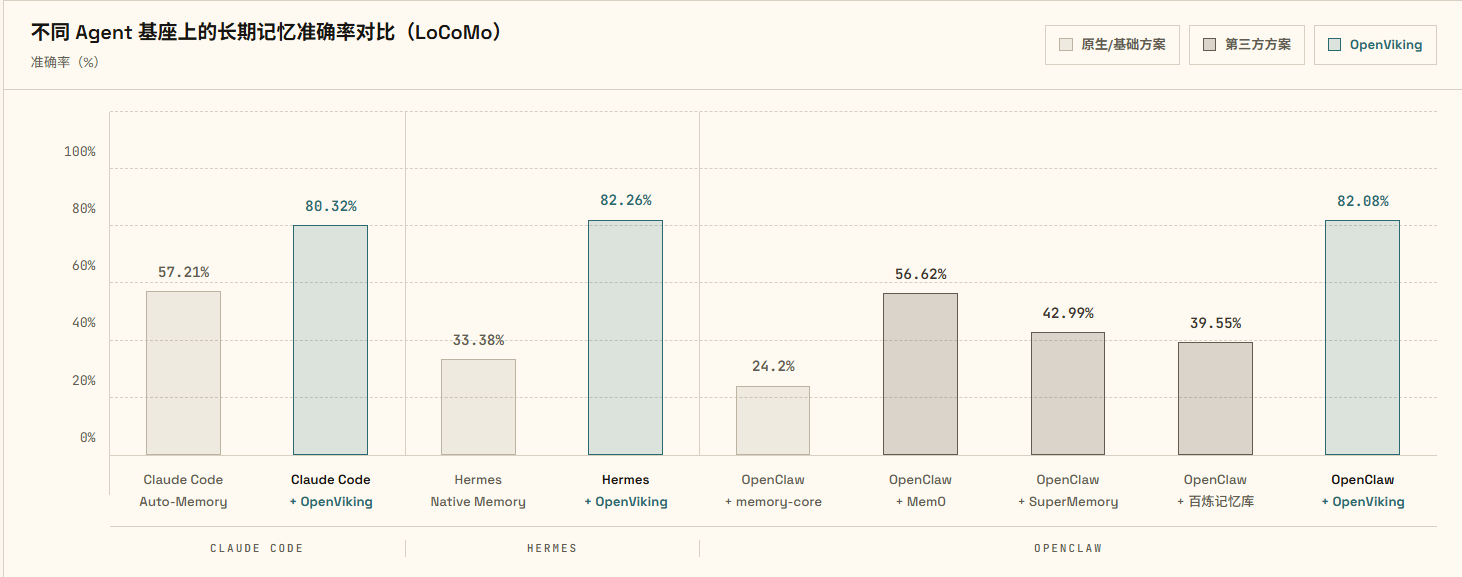
长期记忆准确率对比
总输入 Token 消耗对比
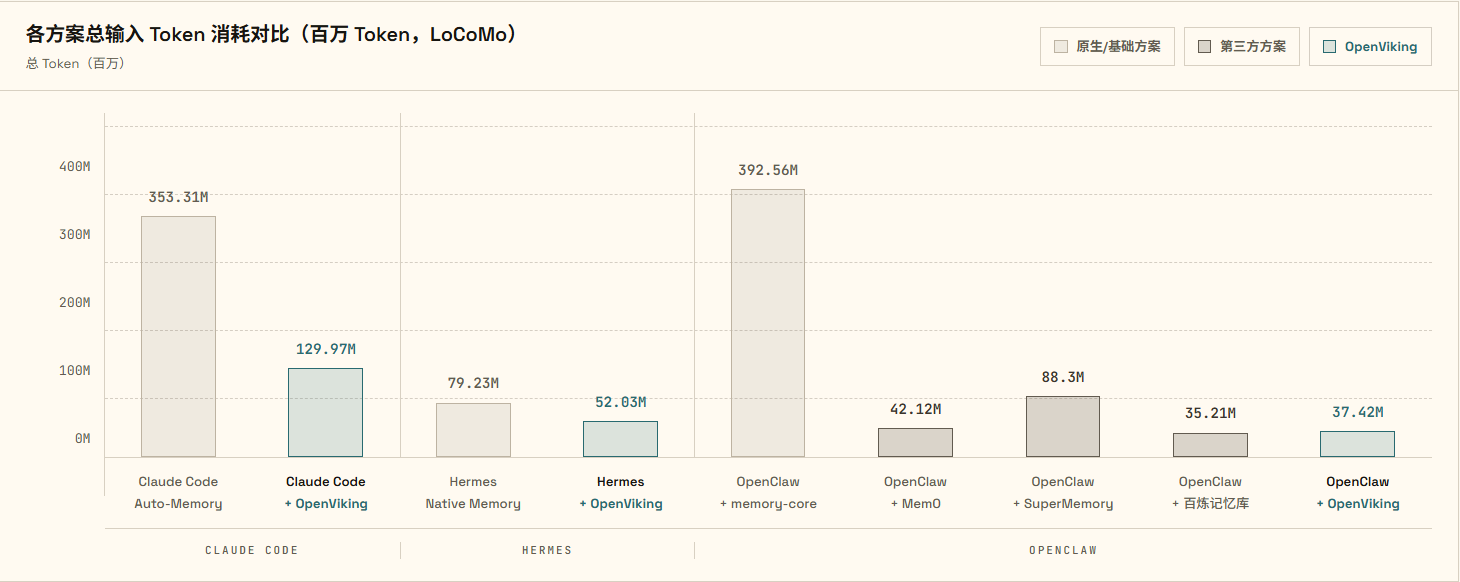
关键结论:OpenViking 在 Claude Code、Hermes、OpenClaw 三组基座上都把长期记忆准确率推到 80%+;在高消耗基线下,输入 Token 最高下降 63%。
3.2 自测实验
自测分为两条相互独立的实验线。两条实验采用不同的观测单位和评价指标,结论不能混用。
| 实验线 | 观测单位 | 主要指标 | 回答的问题 |
|---|---|---|---|
| 端到端长任务对照 | 一次完整的多段任务 | 交付完整度、墙钟时间、费用、缓存、产物质量 | 跨会话记忆是否有助于持续完成复杂任务 |
| 资源检索对照 | 一次 /search/find 请求 |
Recall、Hit、MRR、目录节点占位、延迟 | 检索配置能否更准确地返回目标文档 |
端到端实验会同时受到模型随机性、任务难度、工具调用和 Prompt Cache 的影响,不能直接换算为召回准确率;资源检索实验只评价 Resource 检索,也不能代替真实任务中的交付质量评估。
3.2.1 长任务实验设计
实验任务是从市场调研开始,完整制作一款可离线运行的单文件肉鸽卡牌游戏《灰烬牌局》。任务包含市场报告、市场分析、游戏策划、游戏制作、游戏优化和游戏评价 6 个阶段,拆成 5 段连续执行。工作目录中预置 38 篇、约 37 万字符的资料,覆盖市场、竞品、设计、数值、技术和评价六类内容。
完整跑批包含 A0、A1、A2 三个实验臂,共 15 个运行单元,连续执行约 10 小时。A1 用于观察商业版表现,核心结论主要比较 A0 与 A2。
| 实验臂 | OpenViking 环境 | 命名空间状态 | 用途 |
|---|---|---|---|
| A0 原生 | 不接入 OpenViking | 不适用 | 纯 Claude Code 对照组 |
| A1 商业版 | 商业版 v0.4.17.3 |
空命名空间 | 观察官方托管版本;不作为 A2 的直接归因对照 |
| A2 公司网关 | 公司网关 + 上游 v0.4.12 |
已有用户级记忆 | 验证实际生产接入形态 |
三个实验臂使用相同的 claude-opus-5、Claude 中转站、题面、资料库和运行限制。不同版本与命名空间状态被单独标注,避免将 A1 与 A2 的差异全部归因于网关。
| 控制项 | 设置 |
|---|---|
| 模型 | claude-opus-5 |
| 资料 | 38 篇、约 37 万字符,覆盖市场、竞品、设计、数值、技术和评价 |
| 会话边界 | 每段使用全新会话,段间清空模型上下文 |
| 单元上限 | 45 分钟或 50 美元,任一上限先到即停止 |
| 执行方式 | 三个实验臂串行运行,避免共享中转密钥的其他流量干扰逐单元计费 |
| 隔离方式 | 独立 USERPROFILE、CLAUDE_CONFIG_DIR、工作目录与 Peer ID |
每段结束后立即关闭会话。A0 依赖工作区文件和 Claude Code 原生机制恢复状态;A2 在此基础上额外使用 OpenViking 的自动召回与捕获能力。第 2~5 段开头设置记忆探针,要求模型回答上一阶段采用的方案、被否决的方案及原因;无法确定时必须明确回答“不记得”。其中部分取舍信息不会写入交付文档,因此能够区分文件反推与跨会话记忆。
实验执行流程如下:
- 预检隔离。 A0 必须满足 MCP 工具、Hook 日志和上下文注入均为 0;A1、A2 必须能够连接各自的 OpenViking 服务。
- 分段执行。 三个实验臂在同一段中接收完全相同的任务范围,运行完成后保存回答、Transcript、事件流和产物。
- 提交屏障。 每段结束后等待 OpenViking 服务端完成会话提交与记忆抽取,再启动下一段,避免下一会话早于记忆入库。
- 产物验证。 检查
index.html是否单文件、是否存在外链、能否离线加载,并记录文档、脚本和自检结果。 - 费用核对。 正常结束的运行读取
modelUsage计算费用;超时运行使用中转站逐单元账本差值。两种口径在可同时取得数据的运行中差异不超过4e-6美元。
隔离记录显示,A0 在五段中始终为 0 个 OpenViking MCP 工具、0 条 Hook 增量和 0 次上下文注入;A2 始终暴露 13 个 MCP 工具,并在各段产生上下文注入。由此可以排除 A0 意外加载 OpenViking 插件这一类实验污染。
3.2.2 长任务实验结果
端到端结果如下:
| 指标 | A0 原生 | A2 OV 记忆库 | 对比结果 |
|---|---|---|---|
| 完成交付阶段 | 4 / 6 | 6 / 6 | A2 补齐游戏优化与评价阶段 |
| 总耗时 | 209.7 分钟 | 185.0 分钟 | 减少 11.8% |
| 总费用 | 52.91 美元 | 47.22 美元 | 减少 10.8% |
| 自然结束的运行单元 | 1 / 5 | 2 / 5 | A0 有 4 个运行单元触及 45 分钟上限 |
| 第 5 段单位费用产出 | 开局的 47% | 开局的 95% | A2 的成本曲线更稳定 |
| 缓存写占比 | 4.72% | 4.64% | 未观察到额外的 KV Cache 失效 |
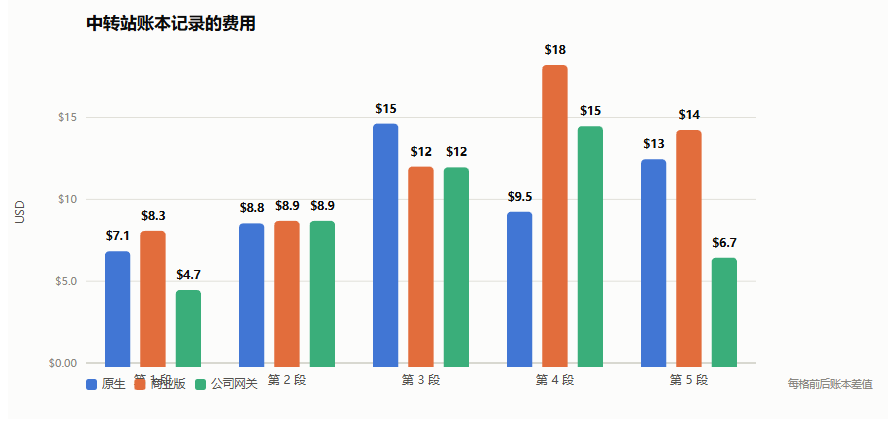
图:三臂各段的中转站账本费用。第 2~4 段大多运行至 45 分钟上限;A2 在第 5 段提前完成,因此该段费用明显下降。
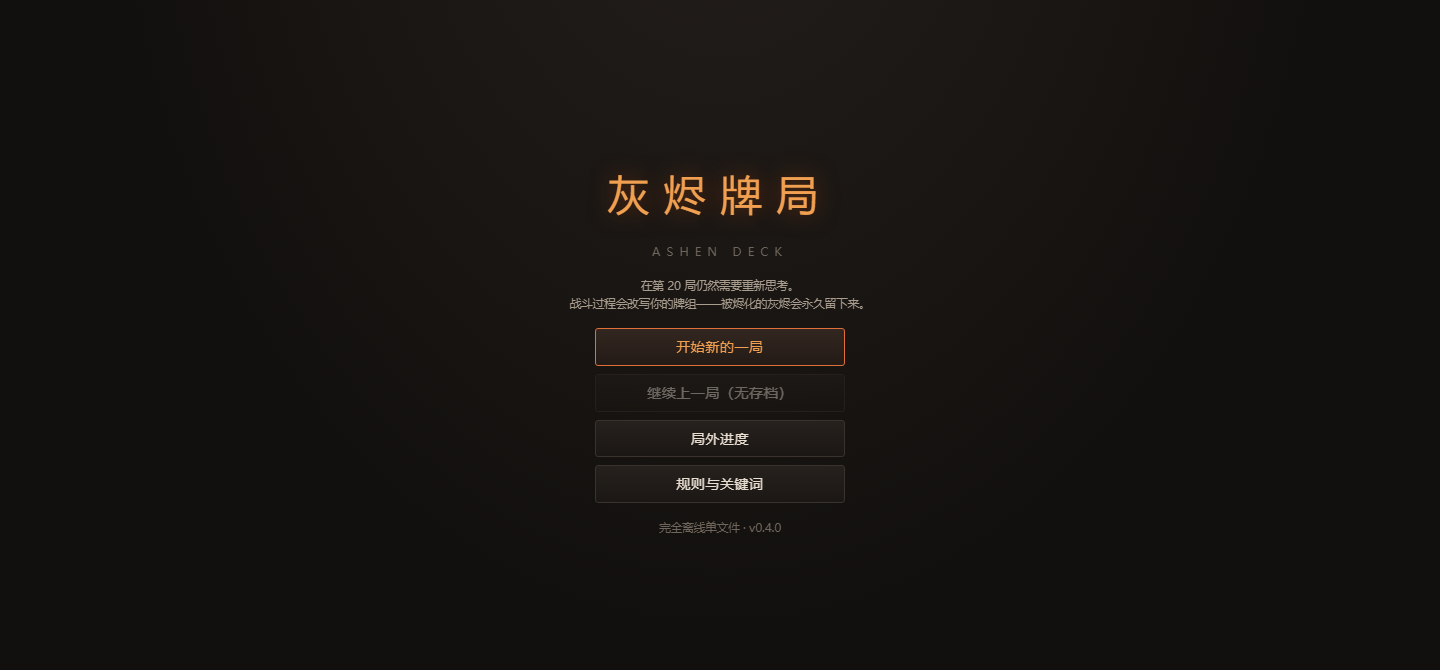
两臂最终都生成了无外链、可断网运行的单文件 index.html。以下截图来自无头浏览器对最终产物的实际渲染,而非设计稿。
| A0 原生 | A2 OV 记忆库 |
|---|---|
 |
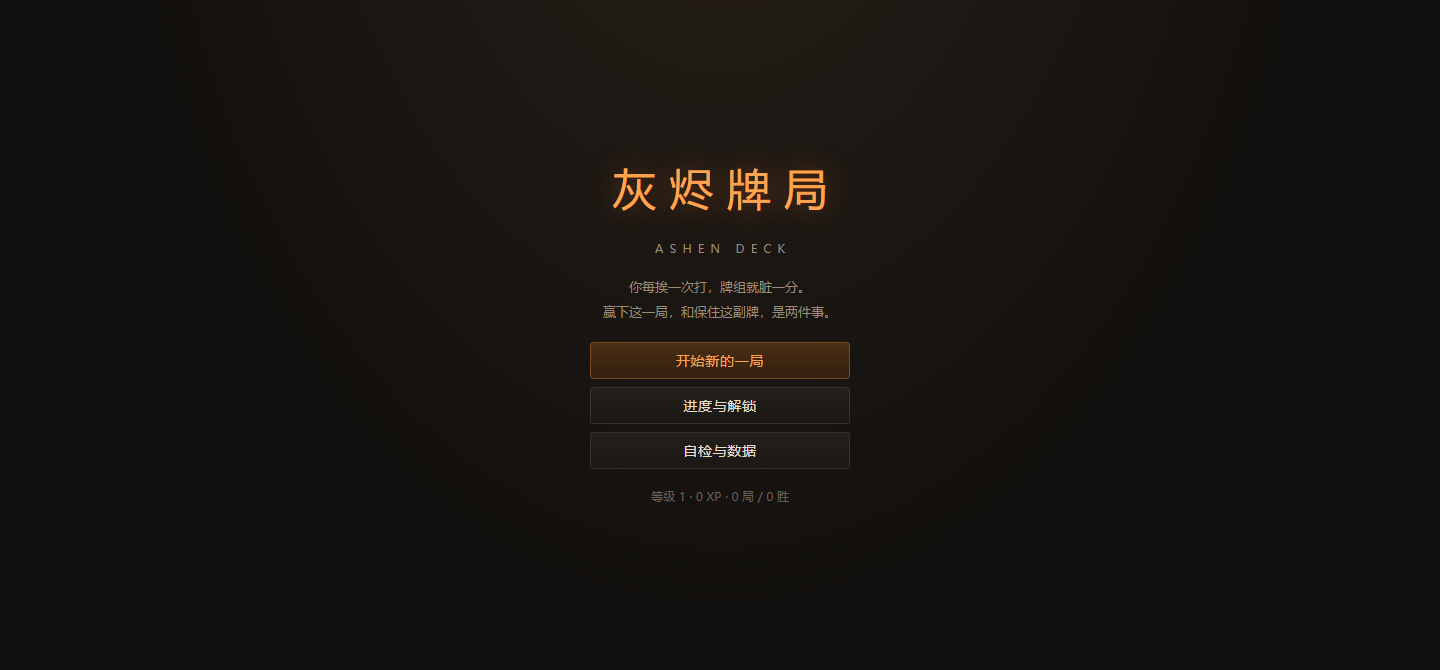 |
图:A0 与 A2 最终交付的《灰烬牌局》启动界面。两者均为单文件离线游戏,但功能组织和后续验证完整度存在差异。
A2 在最后一段用 30.9 分钟完成收尾,并交付评价文档和模拟脚本;A0 运行满 45 分钟后仍缺少游戏优化和游戏评价两个阶段的文档。A2 还在游戏中内置了 27 项数据完整性与可复现性断言,覆盖卡牌引用、敌人数量、事件数量、费用范围、随机数生成和状态迁移等项目,全部执行通过。
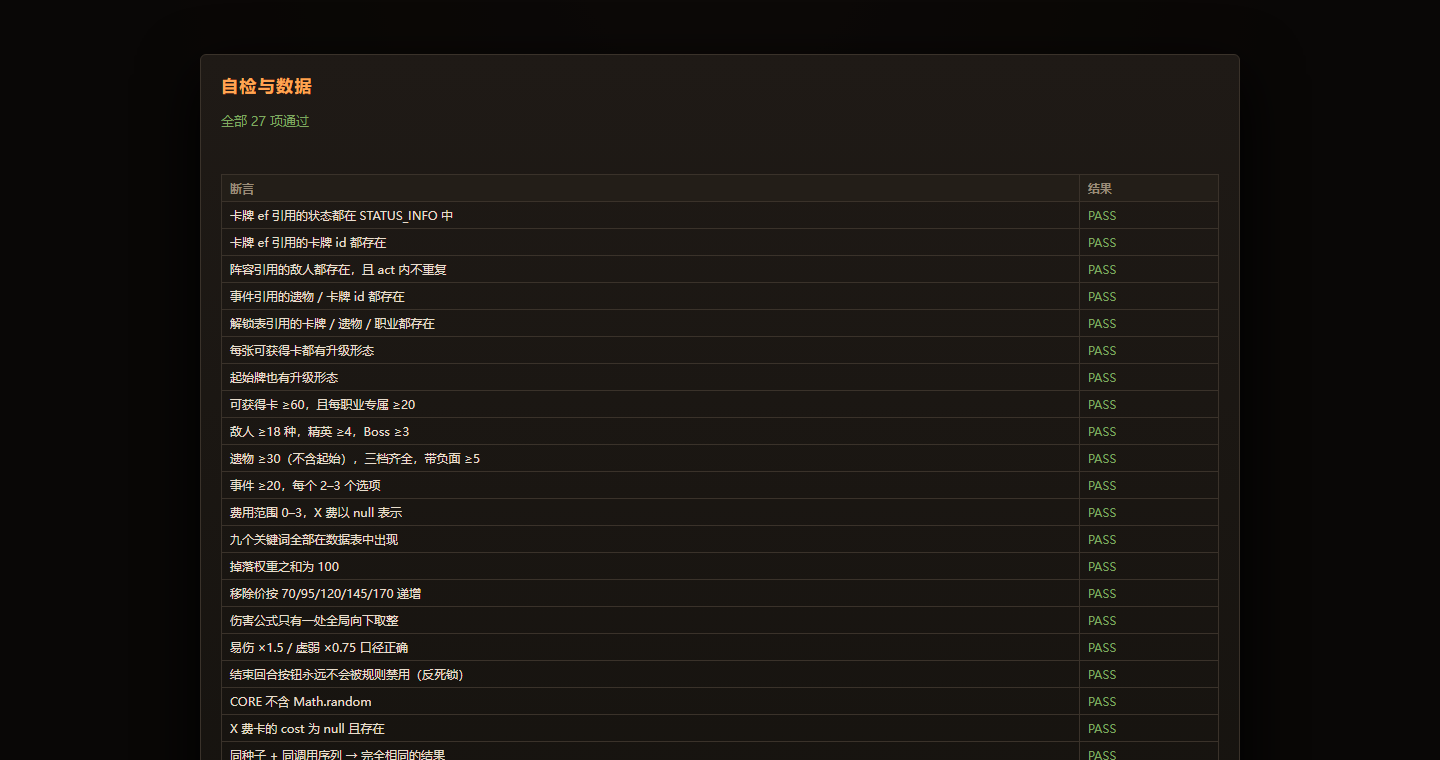
图:A2 产物内置的自检页面,27 项断言全部通过。
从结果中可以得到四项观察:
- 主要差异出现在任务后段。 第 1 段不依赖历史决策,记忆优势尚不明显;进入优化与评价阶段后,早期方案和数值框架能否被恢复,直接影响交付完整度。
- 时间和费用同时下降。 A2 相比 A0 减少 24.7 分钟和 5.69 美元,交付完整度的提升并非以更高的总费用为代价。
- 单位成本更稳定。 到第 5 段,A0 每美元输出 Token 降至第 1 段的 47%,A2 仍保持 95%,表明重复理解既有项目逐渐成为 A0 的主要成本来源。
- 未观察到额外缓存破坏。 A2 的缓存写入占比为 4.64%,A0 为 4.72%。接入增加的是工具定义与启动注入形成的固定前缀,而不是持续改写系统前缀。
OpenViking 的 13 个 MCP 工具定义及启动注入会增加约 5,350 Token 的固定前缀,本轮折算约 1.07 美元,占 A2 总费用的 2.3%。因此,接入后并非从第一轮开始就必然降低成本;只有当任务跨越多个会话、并反复依赖既有决策时,固定开销才会被后续收益抵消。
**实验边界:**每个运行单元只执行 1 次,即
n=1;同时,A2 使用的是公司网关和已有用户空间,并非完全空白的 OpenViking 命名空间。因此该结果适合作为端到端案例和机制验证,不能当作稳定的性能分布,也不能把全部差异都归因于 OpenViking 本身。若要获得统计结论,还需要使用干净命名空间完成至少 3 次重复运行,并对最终产物做独立盲评。
3.2.3 资源检索终验
第二条实验直接调用生产环境的 /search/find。测试集冻结为 288 条查询,其中正例 255 条、负例 33 条,覆盖 40 篇资源文档。问题按照实际任务需求构造,例如询问起始生命、稀有度权重或存档迁移,而不是直接复述文档标题;负例用于观察系统是否对语料中不存在的主题仍然返回结果。
主要指标含义如下:
| 指标 | 含义 |
|---|---|
| Recall@k | 预期目标文档是否进入前 k 条结果 |
| Hit@k | 查询是否在前 k 条中命中至少一个相关结果 |
| MRR | 首个相关结果排名倒数的均值,越高表示目标文档排序越靠前 |
| 目录节点占位 | 返回结果被目录摘要占用的数量,过高会挤占正文文档位置 |
测试环境以生产上游 OpenViking v0.4.12 为基线。最终配置并非单一参数变更,而是以下组合方案:
| 变更 | 作用 |
|---|---|
| 事实型摘要模板 | 将摘要从编目式描述调整为可直接检索的事实陈述;主要收益体现在注入长度 |
qwen3.7-text-embedding |
提升查询与目标文档之间的语义区分度;更换后对 3,607 条向量完成全量重嵌入 |
level=[2] |
只检索文件节点,减少目录摘要占用排序位置 |
limit=6 |
在召回覆盖率与返回长度之间取平衡 |
| 国内 Embedding 端点 | 保持同一模型和向量空间,同时降低跨地域调用延迟 |
最终配置在相同测试集、相同过滤口径下复测,结果如下:
| 指标 | 基线 | 最终配置 | 变化 |
|---|---|---|---|
| Recall@1 / @3 / @5 | 0.3559 / 0.5242 / 0.6255 | 0.4065 / 0.6092 / 0.6895 | +14.2% / +16.2% / +10.2% |
| Hit@1 / @3 / @5 | 0.4000 / 0.5804 / 0.6745 | 0.4667 / 0.6706 / 0.7412 | +16.7% / +15.5% / +9.9% |
| MRR | 0.4976 | 0.5763 | +15.8% |
| 前五条结果中的目录节点数 | 435 | 36 | 减少 91.7% |
| P50 延迟 | 188 ms | 151 ms | 减少 20% |
| P95 延迟 | 394 ms | 437 ms | 增加 11% |
七项精度指标均提升 9.9%~16.7%,目录节点占位由 435 个下降至 36 个。残留的 36 个节点来自被索引为 L2 文件的 .abstract.md 或 .overview.md,因此无法仅通过 level=[2] 完全排除。
参数扫描也修正了早期结论:在较小测试集上,limit=4 曾表现为可降低 Token 且不损失精度;在冻结的 288 条测试集上,limit=4 会使 Recall 下降 0.061、命中率下降 0.051,因此最终改为 limit=6。该结果表明,检索参数必须绑定具体基线与数据集,不能脱离实验条件复用。
延迟方面,P50 从 188 ms 降至 151 ms,但 P95 从 394 ms 增至 437 ms。中位延迟已经改善,长尾仍有 11% 的增幅,后续仍需关注连接复用、TLS 握手和模型端点抖动。
需要强调的是,该实验测量的是 Resource 的 /search/find 检索,不是每轮自动执行的 Memory Recall。两条链路共享 Embedding 与部分排序机制,但查询范围、配额和注入策略不同,趋势可以参考,数值不能直接互换。最终数据也是多项配置组合后的整体结果,不能全部归因于某一个模型或某一个网关参数。
3.3 使用体验
3.3.1 接入与日常使用
实际使用环境覆盖 OpenViking 商业版、自建服务、OpenViking Helper,以及 Claude Code、Codex 等 Agent。商业版接入步骤较少,并支持自动更新;自建服务的配置与数据控制能力更强,但需要自行维护模型端点、向量索引、权限、异步队列和版本升级。
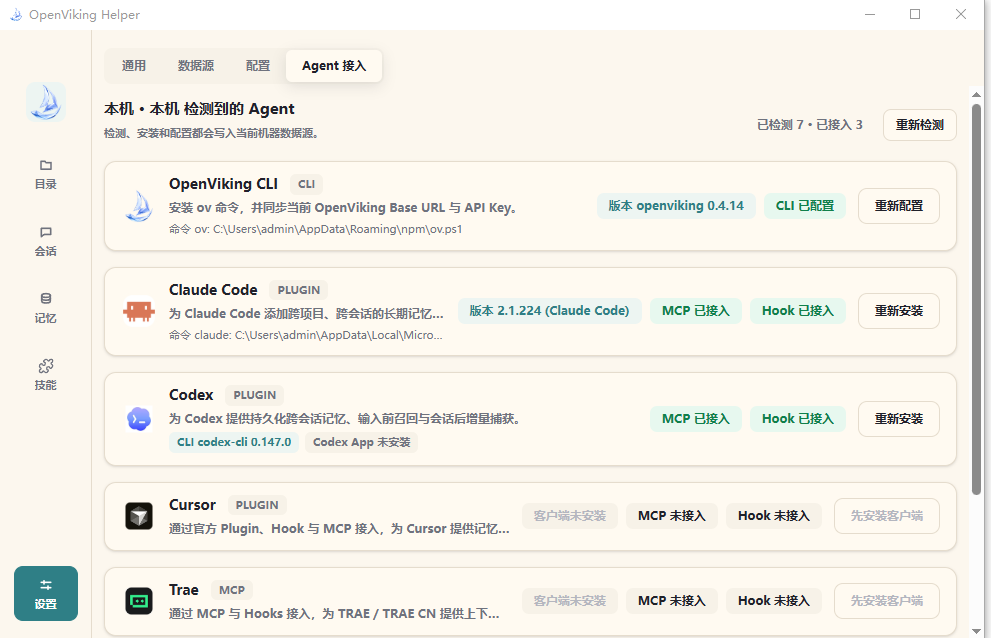
图:OpenViking Helper 的 Agent 接入页,可直接检查本机 CLI、MCP 与 Hook 状态。图中显示的是本机客户端版本,不等同于服务端版本。
OpenViking Helper 适合用于日常检查:可以配置本地 Agent、查看会话中的召回与捕获事件,并同步本地记忆和 Skill。它将原本隐藏在插件后台的动作可视化;当发生错误召回、身份不匹配或记忆未写入时,可以沿会话、URI 和事件记录定位问题。
CLI 安装本身较为直接,主流 Agent 均提供对应接入方式。实际部署中,安装完成并不等于接入有效,至少应核对以下项目:
| 检查项 | 核对内容 |
|---|---|
| 服务配置 | ovcli.conf 中的 Base URL、API Key、account 与 user 是否匹配 |
| Agent 接入 | MCP 与 Hook 是否均处于已接入状态 |
| 身份作用域 | 当前用户、项目 Peer 与 Resource 命名空间是否符合预期 |
| 服务健康 | 模型、系统状态和任务队列端点是否正常 |
| 首次会话 | SessionStart 是否出现注入记录,Stop/PreCompact 后是否生成提交任务 |
接入后的工作流由生命周期 Hook 与显式工具共同组成:
| 阶段 | 自动行为 | 可观测结果 |
|---|---|---|
| SessionStart | 注入用户画像、记忆索引和会话摘要 | Prompt 中出现 OpenViking 上下文块 |
| UserPromptSubmit | 根据当前问题检索相关记忆 | 生成召回事件和命中 URI |
| Stop | 捕获本轮新增消息 | 会话记录增加,等待后续提交 |
| PreCompact / 正常结束 | 提交完整会话并触发记忆抽取 | 生成提交任务和 memory_diff.json |
| 显式调用 | 通过 Skill 或 MCP 执行搜索、读取、写入和目录浏览 | 返回确定的 URI、正文或写入结果 |
“自动召回 + 显式工具”的混合方式兼顾了低操作负担与人工控制能力。常规对话依靠自动 Hook 完成;重要事实需要立即写入、自动检索不准确或需要读取指定文档时,再切换到显式工具。在一次 Claude 会话导入中,先读取 OpenViking 记忆、再读取本地项目记忆,全过程只占用了约 9% 的上下文上限。
需要注意,记忆抽取与向量写入是异步过程。若在上一会话结束后立即启动下一会话,可能出现提交已发出但记忆尚未进入可检索状态的短暂窗口。对强依赖上一阶段决策的自动化流程,应设置任务完成屏障,或在下一阶段开始前检查提交状态。
3.3.2 体验较好的部分
| 方面 | 实际感受 |
|---|---|
| 确定性寻址 | Resource、Memory 与 Skill 统一使用 viking:// URI,可通过 ls、find、grep 和 read 定位;召回结果能够回溯到具体路径。 |
| 分层披露 | L0 用于相关性判断,L1 用于目录导航,L2 承载正文;只有确认相关后才读取详细内容。实测一次会话导入仅占上下文上限的约 9%。 |
| 跨会话接续 | 新会话可以恢复用户偏好、项目背景和上一阶段决策;五段长任务中,A2 完成 6/6 阶段,A0 完成 4/6。 |
| 不破坏前缀缓存 | 上下文注入采用追加方式,缓存写入占比为 4.64%,未高于未接入时的 4.72%。 |
| 团队隔离 | 同一服务内可共享项目 Resource,同时按用户隔离 Memory;account、user 与 peer 构成不同层次的访问边界。 |
| 可治理与可审计 | 会话、记忆和检索轨迹均可观察;提交时生成变更记录,便于定位错误抽取和权限问题。 |
实际使用中,记忆召回与普通回复的等待时间通常处于可接受范围。收益最明显的场景不是一次性短对话,而是数据库整理、多文件研究和持续开发等大上下文工作:任务持续时间越长,可复用的决策、偏好和经验越多,跨会话收益越容易覆盖固定接入成本。
3.3.3 当前边界
- 知识条目之间缺少横向关系。 当前优势主要来自目录与纵向分层,独立条目之间缺少可直接遍历的交叉引用。随着条目增加,仍需依赖全文扫描或向量检索发现关联。
- 早期路由错误难以后续纠正。 层级检索先确定目录、再检索文档;若目录阶段选择错误,正确文档不会进入候选集,后续 Rerank 无法恢复。本项目路由实验的 Top-1 为 49.2%、Top-3 为 74.2%,目录设计仍会直接影响召回上限。
- 接入存在固定成本。 工具定义、用户画像和自动召回增加约 5,350 Token 的首轮前缀;短任务可能只有开销,没有足够的后续轮次摊薄成本。
- 记忆质量不会自动得到保证。 错误、重复、冲突和过期内容仍需通过 Schema、抽取策略、容量限制、权限和清理机制治理。
- 不同宿主的生命周期能力不一致。 例如 Codex 被
SIGTERM、Ctrl+C或/exit终止时可能不触发结束 Hook,需要在下次启动时回收孤儿会话。重要任务应正常结束或主动提交。 - 商业版成本需要提前评估。 Session 会保存消息和工具输出;若按文件数量、文件大小、模型调用和流量计费,长期高频使用会形成持续费用。
- 自建服务具有明确的运维负担。 模型端点、向量一致性、队列恢复、版本差异、权限隔离和可观测性都需要专门配置。实测自建上游
v0.4.12与商业版v0.4.17.3已存在能力差异,因此不能将不同版本的结果直接归因于部署形态。
3.3.4 适用场景判断
| 更适合采用 | 不宜优先采用 |
|---|---|
| 需要跨多次会话持续推进的研发或研究任务 | 一次会话即可完成、历史信息很少的短任务 |
| 多人或多 Agent 共享项目资料、但需要隔离个人记忆 | 只有少量静态文档、普通目录检索已经足够的场景 |
| 需要查看记忆来源、检索轨迹和变更记录的审计场景 | 无法承担模型、向量库、权限和队列维护成本的项目 |
| 上下文持续增长,重复阅读成本已经可观测的项目 | 要求写入后立即强一致可见、且不能设置等待屏障的流程 |
综合来看,OpenViking 的核心价值是将上下文从一次性 Prompt 输入转化为可寻址、可分层、可复用和可治理的长期资产。它适合长周期协作与大上下文任务,但不替代 Agent 编排,也不会自动将低质量对话转化为高质量记忆;最终效果仍取决于数据组织、抽取策略、权限边界和持续评测。
4 迁移解剖与联想:上下文文件系统还缺什么
前三节已经说明 OpenViking 的结构、检索链路和实测效果。本节不再重复功能清单,而是按照“迁移解剖—阻抗核对—联想推广”的方法回答三个问题:它从文件系统中迁移了什么,经典文件系统的哪些前提在 LLM 场景中不再成立,以及这些差异还能推出哪些可验证的设计。在本章节,加粗字体为比较有吸引力的可靠的内容。
4.1 原型界定:迁移的不是目录外观,而是上下文管理结构
OpenViking 的直接原型是文件系统,但它并非只借用了“文件夹”这一表面隐喻。真正发生迁移的是一组互相配合的机制:用统一命名空间组织异构数据,用路径提供确定性寻址,用目录缩小检索范围,用分层内容控制读取成本,再用会话提交把运行过程沉淀为长期记忆。
| 经典系统中的角色 | OpenViking 中的对应物 | 被保留的性质 | 面向 LLM 的改造 |
|---|---|---|---|
| 路径名 | viking:// URI |
路径已知后可确定性定位 | 路径发现可由语义检索完成,结果具有概率性 |
| 目录 | Resource、Memory、Skill 的层级树 | 分组、遍历和局部搜索 | 目录同时包含模型生成的摘要,可参与路由 |
| 文件正文 | L2 详细内容 | 承载可完整读取的内容 | 正文既可能来自原始资源,也可能来自会话抽取 |
| 目录项与元数据 | L0、L1、向量索引 | 先检查低成本信息,再决定是否读取正文 | 摘要与向量由模型生成,可能过期或失真 |
| 文件操作 | ls、tree、read、grep、glob、mv、rm 等操作 |
操作对象和结果可追踪 | 通过 API、MCP 和自然语言工具调用暴露给 Agent |
| 用户与进程边界 | account、user、agent、peer 等作用域 | 形成不同层次的可见范围 | 权限边界无法等价为指令与数据的硬隔离 |
| 写入与整理 | Session Commit、记忆抽取与索引任务 | 将临时状态转为可复用状态 | 提交包含压缩、抽取和异步索引,并非简单字节落盘 |
由此可以区分三层迁移深度:
- 概念迁移已经明确发生。 URI、目录树、文件操作和作用域直接借用了文件系统语言。
- 架构迁移已经形成主体。 命名空间、分层读取、确定性操作与检索索引共同参与运行,而非只用于界面展示。OpenViking 实际上更接近“虚拟文件系统 + 数据库索引 + 会话压缩管线”的组合。
- 问题迁移只完成了一部分。 上下文管理被重述为寻址、索引、装载和治理问题,但稳定身份、原子提交、锁、故障恢复和强权限等文件系统契约尚未完整迁入。
其中,L0/L1/L2 不应简单理解为传统文件系统的缓存层。更准确的对应是“目录项/摘要/正文”三级披露:它们解决的是 Agent 应该看多少内容,而不是内核应该把哪些数据页保留在内存。Session Commit 也更接近日志压缩和物化视图生成,而不是 POSIX fsync 或完整事务。
4.2 阻抗失配:文件系统假设进入 LLM 场景后发生了什么
原型迁移是否有效,取决于原系统的前提能否在新环境中成立。OpenViking 已经处理了部分失配,但尚未消除它们。
| 文件系统中的隐含前提 | LLM 场景中的失配 | OpenViking 的处理 | 尚存代价或风险 |
|---|---|---|---|
| 给定路径即可确定定位 | 用户通常只表达意图,不知道 URI | 用 find/search 发现候选,再用 read(uri) 确定读取 |
目录路由一旦选错,后续排序无法看到正确文档;路由实验 Top-1 仅 49.2%、Top-3 为 74.2% |
| 一个对象通常位于一个父目录 | 同一知识可能同时属于多个主题、项目和任务 | 可依赖向量检索跨越目录发现内容 | 当前横向关系未形成主要检索通道,多归属仍依赖复制或概率检索横向记忆能力查,即一个类似内容在不同resource或记忆的相关。 |
| 写入完成后状态立即可见 | 摘要生成、向量化和记忆抽取是异步任务 | 通过任务队列完成派生数据写入 | 内容、摘要与索引可能短暂不一致,强依赖前序结果的流程需要完成屏障 |
| 系统调用具有严格参数和错误契约 | Agent 通过自然语言选择并调用工具 | MCP/API 将操作约束为结构化接口 | 工具选择仍可能出错,运行时校验不能省略 |
| 访问控制等于内容安全 | 文档内容还可能包含针对模型的恶意指令 | account、user、peer 控制可见范围 | 命名空间不能提供硬件式“指令位”,Prompt Injection 仍需独立防护 |
| 保存进程状态可以近似恢复执行 | 模型内部状态不可序列化,长对话还必须压缩 | 保存消息并抽取事件、实体、偏好和摘要 | 恢复的是有损代理状态,不是模型思考过程的完整快照 |
| 元数据读取成本很低 | L0/L1、Embedding 和 Rerank 都可能产生模型成本 | 以渐进披露减少不必要的 L2 读取 | 短任务可能无法摊薄约 5,350 Token 的固定接入开销 |
| 相同输入产生稳定测量 | 模型、网络端点和检索链路均存在波动 | 使用冻结数据集和相同过滤口径比较 | 长任务对照仍为 n=1,只能作为案例证据,不能视为稳定分布 |
这组失配解释了第三节结果中的“收益与边界并存”:分层索引使 Recall@5 从 0.6255 提升到 0.6895,并将前五条结果中的目录节点数从 435 降至 36;与此同时,P95 从 394 ms 增至 437 ms。迁移解决了平均意义上的内容筛选,却没有自动消除长尾延迟、异步一致性和概率路由问题。
4.3 纵向联想:文件系统还有哪些机制可以继续迁移
纵向联想不是把文件系统术语逐项照搬,而是从已经成立的角色映射中寻找缺口。结合当前实现与本地实验,可将候选机制分为“已有但未充分生效”和“尚需补足”两类。
| 经典机制 | 当前状态或实验依据 | 可继续迁移的方向 |
|---|---|---|
| inode 式稳定身份 | URI 同时承担路径与对象定位;移动或重命名会改变外部地址 | 为上下文节点分配与路径无关的稳定 context_id,路径只作为目录项 |
| 硬链接、符号链接与反向链接 | 关系基础设施存在,但当前配置中 memory.link_enabled = false,检索也未使用反向链接加权 |
允许一个节点出现在多个主题下,并把引用关系纳入召回和解释 |
| 工作集与冷热分层 | retrieval.hotness_alpha = 0.0,热度未参与排序;当前也没有自动容量上限和 LRU 式淘汰 |
建立工作集、冷存储和保留策略,限制长期记忆无限增长 |
| 目录分数向下传播 | retrieval.score_propagation_alpha = 1.0,父目录得分未实际影响子节点排序 |
将可靠的目录路由信号传递给叶子节点,同时保留跨目录补救通道 |
WAL、事务与 fsck |
内容、摘要、向量和关系由多阶段任务生成,维护与孤儿清理仍需要显式执行 | 记录提交日志,并提供跨存储对账、重放与修复工具 |
| 快照、导入与备份 | CLI 已有 snapshot 的 commit/restore/log/diff,也有 export/import/backup/restore |
重点不应是重复增加命令,而是验证快照是否覆盖全部派生索引及恢复一致性 |
| mount 与 overlay | 项目 Resource、个人 Memory 和 Skill 已有不同作用域 | 将组织政策、项目资料和个人上下文以只读层、可写层叠加,明确覆盖优先级 |
| capability 与只读挂载 | 已有身份和命名空间隔离 | 将“能看到”细化为可检索、可读取、可修改、可分享等最小能力 |
这些候选项的优先级并不相同。稳定身份、原子提交和一致性检查直接影响数据正确性,应先于复杂图检索;关系遍历和热度淘汰只有在条目规模增长后才会显著体现收益;overlay 与细粒度 capability 则主要面向团队和多 Agent 场景。
4.4 横向联想:同一结构还能迁移到哪些 LLM 问题
OpenViking 可被抽象为一个更一般的结构:确定性地址 + 概率性发现 + 渐进式装载。只要目标问题也同时存在“对象很多、完整加载昂贵、最终操作必须可追踪”三个条件,这一结构就可能横向迁移。以下联想均给出角色映射、测量指标和失败条件,避免停留在表面类比。
| 候选场景 | 角色映射 | 可测指标 | 失败条件 |
|---|---|---|---|
| MCP 工具定义按需加载 | 文件对应完整工具 Schema,URI 对应工具名,L0 是一句话用途,L1 是参数概览,L2 是完整 Schema 与说明 | 系统前缀 Token、工具选择准确率、首次调用延迟 | 模型在未读取 L2 前无法可靠选中工具,或节省的 Token 小于额外路由成本 |
| 多 Agent 共享工作区 | 文件对应任务上下文片段,目录对应项目/任务树,Commit 对应 Agent 结果提交,版本号用于发现并发修改 | 重复读取量、冲突率、合并耗时、任务完成质量 | 共享结构增加协调开销,却没有降低重复工作或冲突 |
| 政策与指令治理 | 组织、项目、用户政策分别映射为只读挂载层,Agent 只获得任务所需 capability | 无权访问率、越权修改率、政策命中率、提示词开销 | 内容中的恶意指令仍越过政策层,或层间优先级无法确定 |
第一项具有直接的实验动机:当前 13 个 OpenViking MCP 工具带来约 5,350 Token 的固定前缀。如果只常驻工具的 L0 索引,在确定需要后再加载完整 Schema,理论上可以降低短任务的固定成本。但这一方案只有在工具选择准确率不下降时才成立,不能仅以 Token 下降判定成功。
4.5 反向联想:LLM 的特化机制能否回流经典系统
迁移并非只能从经典系统流向 LLM。OpenViking 为概率模型增加确定性边界时形成的机制,也可以反向用于传统信息系统:
- 语义寻址回流文档库或 IDE。 用户先用自然语言描述意图,系统返回可审计的规范路径、命中理由和遍历轨迹;语义检索负责发现,路径负责后续确定操作。
- L0/L1 边车回流数据湖和归档系统。 为大文件生成一行摘要和结构概览,使人或自动化程序在打开全文前完成低成本筛选。
- 会话压缩回流客服与事故知识库。 将连续日志抽取为事件、实体、决策和待办,同时保留到原始记录的引用,降低复盘时的全量读取成本。
反向迁移同样有边界:生成式摘要与语义寻址具有概率性,不应进入内核启动、账务一致性或安全授权等要求确定正确的关键路径。它们适合承担发现、导航和解释,最终修改仍应落到规范路径、版本和强校验接口上。
4.6 候选设计:稳定上下文身份与原子提交
综合纵向和横向联想,可以提出一个可证伪的候选设计:稳定上下文身份 + 多父关系 + 原子上下文提交。该设计属于推断,不代表 OpenViking 当前已经实现。
设计包含五项最小改动:
- 每个上下文节点获得不可随移动和重命名变化的
context_id,viking://URI 退化为指向该节点的目录项。 - 关系限定为少量有类型的边,例如
contains、references、supersedes和derived_from,避免无约束知识图谱膨胀。 - 同一节点可以通过多个路径或链接出现,但正文只保存一份;反向链接可用于解释召回来源。
- 一次 Commit 必须共同覆盖正文、L0/L1、向量记录和关系更新;失败时能够整体回滚或根据日志重放。
- 提供
fsck式对账,检查正文、目录树、向量索引和反向链接,并结合引用计数与保留策略回收孤儿节点。
借用wiki的存储方法,可参考llm-wiki
该设计应在生产基线 v0.4.12 上使用同一冻结的 288 条查询集验证,并增加跨目录引用、移动/重命名和故障注入三类测试。接受标准至少包括:Recall@5 与 MRR 不退化,跨目录子集的召回显著改善;移动或重命名不触发无必要的重新 Embedding;在正文写入与向量写入之间注入失败后,对账恢复的陈旧记录和孤儿记录均为 0;P95 检索延迟增幅不超过预先声明的 10%。精度差异应使用配对 Bootstrap 置信区间,而不是只比较单次点估计。
如果多父关系没有改善跨目录召回,或一致性与延迟成本超过上述阈值,就应否决该设计,而不是因为它“更像文件系统”而保留。由此可见,OpenViking 最有价值的迁移不是目录界面本身,而是把不可控的上下文堆积改写为可寻址、可装载、可审计的问题;其下一阶段的关键,也不是增加更多文件系统术语,而是补足稳定身份、一致性和关系治理,并用可重复实验判断这些机制是否真正改善 Agent 工作。
5 相关项目扩展分享
本节选择两个与 OpenViking 具有直接可比性的项目。它们都把 Agent 的长期状态从一次性 Prompt 中拆出来,但解决的问题并不相同:MemFS 解决“运行中的 Agent 如何组织和修改记忆”,agent-file 解决“一个已经形成的 Agent 如何被打包、迁移和复现”。前者偏运行时,后者偏交换格式。
5.1 Letta MemFS:把记忆变成可提交的工作区
原文链接:MemFS | Letta Docs
5.1.1 核心概念
MemFS(Memory File System)是 Letta Agent 使用的 Git-backed memory filesystem,也可以理解为 Agent 的上下文仓库。每个 Agent 拥有一个 Git 仓库,Letta 将仓库投影为 Agent 当前运行环境中的真实目录;Agent 通过普通的文件工具读取和修改 Markdown 文件,修改在提交前属于本地工作区,提交并推送后才成为其他运行位置可见的长期记忆。
它的关键抽象不是“把聊天记录存成文件”,而是把记忆拆成三种状态:
| 状态 | 典型位置或对象 | 对上下文的意义 |
|---|---|---|
| 当前身份与硬约束 | system/ 下的 persona.md、human.md 等 |
每轮注入,保证 Agent 的基本身份和关键偏好稳定 |
| 可按需读取的长期知识 | reference/、项目目录、主题目录 |
文件树常驻为路标,正文只有在需要时才读取 |
| 可复用的行为程序 | skills/ 下的技能文件 |
记忆与工具使用方法一起版本化,形成可迁移工作流 |
每个记忆文件可以带 YAML frontmatter,用于描述其用途;文件名和目录名本身也承担索引作用。也就是说,MemFS 把“哪些内容始终在上下文中”和“哪些内容需要主动读取”编码进文件布局,而不是把所有历史对话都塞进上下文窗口。
5.1.2 实现原理
MemFS 的运行链路可以概括为“工作区投影—文件编辑—Git 提交—跨位置同步”:
- 仓库投影。 Letta 将 Agent 所属的 Git 仓库检出为运行时目录,Agent 看到的是普通路径,而不是专有记忆 API。
- 渐进式装载。
system/文件在每轮系统提示中加载;其他目录只把树结构作为路标,Agent 通过ls、搜索和读取工具按需打开。 - 提交形成边界。 文件修改先留在工作区;提交后形成版本节点,云端 Agent 再将提交推送到托管仓库,从而在其他设备或运行环境中同步。
- 并发修改使用 Git 机制。 记忆子 Agent 可以使用 worktree 独立修改,主 Agent 通过提交、合并和冲突处理收敛结果,而不是直接覆盖同一份文本。
- 搜索与会话历史分离。 普通文件搜索可直接检索 MemFS;语义或混合搜索需要额外的 Search Mod 和 QMD 索引;聊天消息历史则是另一条检索链路,不能把两者的召回结果混为一谈。
这种设计把“写入记忆”降格为 Agent 熟悉的文件编辑行为,使记忆治理可以复用 Git 的提交、差异、回滚和分支语义。需要注意,Git 只保证版本可追踪和冲突可见,并不保证写入内容正确;错误记忆同样可以被可靠地提交。
5.1.3 主要优点、缺点与预期收益
| 预期收益 | 形成原因 | 需要监测的边界 |
|---|---|---|
| 降低每轮上下文开销 | 仅将核心身份放入 system/,其余内容按需读取 |
文件树和摘要过长时仍会占用固定 Token |
| 提高记忆可解释性 | 每条记忆有路径、正文、提交记录和差异 | Agent 可能选择错误路径,文件存在不等于被正确使用 |
| 支持回滚与审计 | Git commit、diff 和分支提供历史 | 合并冲突、重复事实和过期偏好仍需人工或规则治理 |
| 支持跨设备接续 | 提交推送后,其他投影可拉取同一仓库 | 本地 Agent 未提交的修改不会自动同步 |
| 复用现有工具链 | 文件读写、搜索和版本控制无需重新发明接口 | 仅有关键词搜索时,语义相关但词面不同的内容可能漏召回 |
主要优点
- 记忆可审阅。 记忆就是普通 Markdown 文件,路径、正文和 Git diff 都可以直接检查,适合人工纠错。
- 版本可追踪。 Commit、分支和 worktree 为修改提供时间线,能够回滚到已知状态,并显式暴露并发冲突。
- 上下文开销可控。
system/中的核心内容常驻,其余内容通过文件树和工具按需读取,不必将全部历史对话放入每轮 Prompt。 - 迁移成本较低。 Agent 可以复用文件读写、搜索和 Git 工具,不需要为每一种记忆类型设计专用接口。
主要缺点
- 检索能力依赖工具。 MemFS 默认不是向量数据库;只使用关键词搜索时,表达不同但语义相近的记忆可能无法命中。
- 记忆质量不会自动提高。 Git 能保证版本和差异可见,不能判断内容是否错误、重复、过期或相互矛盾。
- 提交存在同步窗口。 未提交或未推送的修改不会出现在其他运行环境;并发修改还需要处理合并冲突。
- 运行时边界偏单 Agent。 MemFS 主要围绕一个 Agent 的仓库设计,多 Agent 共享、跨租户权限和统一索引需要额外系统支持。
与 OpenViking 相比,MemFS 更强调“让 Agent 像开发者一样编辑记忆”,OpenViking 更强调“服务端统一管理多种上下文并进行分层检索”。MemFS 的确定性来自 Git 路径和提交历史,OpenViking 的发现能力更多来自摘要、Embedding 和目录路由;前者更容易审阅和回滚,后者更适合多租户、跨资源检索与集中治理。
5.2 Agent File(.af):把 Agent 状态做成可交换文件
原文链接:letta-ai/agent-file
5.2.1 核心概念
Agent File 是面向有状态 Agent 的开放文件格式。它不是一个运行时文件系统,而是一份可以导出、下载、导入和归档的 Agent 状态包。当前仓库中的 .af 示例本质上是结构化 JSON,顶层包含 agents、groups、blocks、files、sources、tools、mcp_servers、metadata 和 created_at 等对象。
其目标是把重建一个 Agent 所需的关键状态集中到同一份文件中,典型内容包括:
| 状态类别 | .af 中的内容 |
迁移时的作用 |
|---|---|---|
| 模型配置 | 模型名称、上下文窗口、Embedding 模型等 | 指定运行时能力边界和默认配置 |
| 行为定义 | System Prompt、Tool Rules、标签 | 保留 Agent 的身份、行为约束和工具调用顺序 |
| 记忆与历史 | Memory Blocks、消息历史及 in_context 标记 |
恢复个性、用户信息和当前上下文窗口 |
| 工具实现 | 工具源码、JSON Schema、执行环境变量 | 让 Agent 不只“知道工具”,还携带工具契约 |
| 外部引用 | files、sources、MCP server 配置等 | 描述 Agent 依赖的文件或外部服务 |
| 安全字段 | 导出时将 secrets 置为 null |
避免把凭据直接打包进可分享文件 |
因此,.af 更接近“可移植的 Agent 镜像或检查点”,而不是单独的 Prompt 模板。它保存的不只是知识,还包括行为、工具和一部分运行历史。
5.2.2 实现原理
Agent File 的实现重点在序列化协议和适配器,而不是检索算法:
- 导出。 从 Letta 服务中读取 Agent 的配置、记忆块、消息、工具和相关引用,按照统一 Schema 生成
.afJSON 文件。 - 验证。 导入方先校验版本、必填字段、对象 ID 和引用关系,再决定哪些字段能映射到本地框架。
- 映射。 将
system、blocks、tools、messages 等元素映射到目标框架的系统提示、记忆、工具注册和历史消息结构;无法一一对应的功能必须显式降级或拒绝导入。 - 重建。 创建新的 Agent 实例,重新绑定模型端点、执行环境和权限;
.af本身不应携带可直接使用的生产密钥。 - 版本化。
.af可以作为仓库中的二进制/文本资产进行版本控制,也可以作为发布物在不同环境中导入,形成“导出—修改—再导入”的检查点循环。
这套机制的难点不是 JSON 能否解析,而是不同框架对“记忆块”“归档记忆”“工具状态”和“上下文窗口”的语义并不相同。项目 README 已将 Passages、数据源、MCP 配置迁移、多 Agent 文件和跨框架转换列为后续方向,说明当前格式仍主要围绕 Letta 的状态模型设计。
5.2.3 主要优点、缺点与预期收益
| 预期收益 | 形成原因 | 需要监测的边界 |
|---|---|---|
| Agent 可携带、可分发 | 一个文件集中描述行为、记忆和工具 | 外部模型、数据库、文件和网络服务仍需另行准备 |
| 检查点与回滚 | 导出文件可保存某一时刻的完整状态 | 导出时未包含的远程状态无法通过回滚恢复 |
| 跨环境部署 | ADE、REST API 和 SDK 都可以导入 | 跨框架语义不一致时,导入可能只是近似重建 |
| 形成 Agent 生态 | 代理可以像模型、插件一样发布和复用 | 工具源码和提示词的供应链安全需要审核、签名和沙箱 |
| 便于研究复现 | 配置、历史和工具契约集中保存 | 相同文件在不同模型版本、采样参数和外部数据下不保证相同输出 |
主要优点
- 状态打包完整。 System Prompt、记忆块、消息历史、工具定义和模型配置可以放在同一个可传输对象中,比单独分享 Prompt 更接近完整 Agent。
- 部署和分发简单。
.af可通过 ADE、REST API 或 SDK 导入,适合制作模板、检查点和可下载的 Agent 资产。 - 便于版本化与归档。 文件可以进入 Git、制品库或研究数据集,支持差异比较、回滚和长期保存。
- 有利于生态互操作。 统一 Schema 为其他框架提供了适配入口,降低 Agent 在不同平台之间迁移的起始成本。
主要缺点
- 跨框架迁移仍是近似转换。 不同系统对记忆块、归档记忆、工具生命周期和上下文窗口的定义不同,导入后可能需要人工修复。
- 外部依赖没有被真正封装。 模型端点、数据库、文件、网络服务和运行权限通常需要在目标环境重新配置。
- 行为不可完全复现。 模型版本、采样参数、工具返回值和外部数据变化,都可能让同一个
.af产生不同结果。 - 供应链风险集中。 文件可能同时携带系统提示、个人记忆和工具代码;导入前必须进行来源、Schema、权限、沙箱和敏感信息审查。
- 状态覆盖仍不完整。 当前格式对 Passages、数据源、多 Agent 状态和跨框架自动转换等能力仍有限,不能等同于完整运行时快照。
.af 文件还存在一个容易被忽略的安全边界:它可能同时包含系统提示、用户信息和工具代码。导入不能等同于“打开一个文档”,而应经过来源校验、Schema 校验、工具权限审查、代码沙箱和密钥重新注入。尤其不能因为 secrets 被置为 null,就认为整个文件没有敏感信息;记忆块和历史消息本身仍可能包含个人数据、内部地址或业务机密。
5.3 两个项目与 OpenViking 的关系
三者可以按“运行时管理—记忆编辑—状态交换”划分,而不是简单按“谁更像文件系统”排序:
| 系统 | 主要回答的问题 | 状态边界 | 核心机制 | 最适合的场景 |
|---|---|---|---|---|
| OpenViking | 如何在大量上下文中发现、分层读取和治理内容 | Resource、Memory、Skill、Session 及其索引 | viking:// 命名空间、L0/L1/L2、向量检索、异步提交 |
长周期研发、跨会话记忆、多 Agent 共享资源 |
| Letta MemFS | Agent 如何以文件方式编辑和版本化自己的记忆 | 单个 Agent 的 Git-backed memory repository | 真实工作区、Markdown、Git commit、branch/worktree | 需要人工审阅、回滚和跨设备同步的 Agent |
| Agent File | 如何把一个有状态 Agent 打包和迁移 | Agent 配置、记忆、历史、工具和元数据 | Schema 序列化、导出/导入、检查点 | 发布代理、环境迁移、实验复现和归档 |
一个更完整的组合架构可以是:用 .af 保存可迁移的 Agent 初始状态,用 MemFS 管理 Agent 的可审阅工作区,再用 OpenViking 承担跨 Agent、跨项目的长期资源检索。 这相当于把 Agent 状态拆为三层:
1 | Agent File (.af) -> 可迁移的初始快照:身份、工具、记忆块、历史 |
这种组合的收益不是简单叠加。.af 解决“带着 Agent 走”,MemFS 解决“看得见并改得回去”,OpenViking 解决“内容多了以后还能找得到”。但组合也引入了同步协议问题:.af 导入后的初始记忆与 MemFS 提交如何对应,MemFS 的文件修改何时进入 OpenViking 索引,OpenViking 召回的外部资源是否允许被重新导出,都需要明确版本号、来源和权限。
5.4 思想感悟:Agent 的“记忆”正在分化为多种可治理状态
这两个项目与 OpenViking 放在一起,最值得关注的并不是又出现了两个文件格式,而是 Agent 状态正在从一个模糊的“Memory”概念分化为至少四类对象:
- 工作记忆。 当前对话和当前上下文窗口中的内容,追求低延迟和任务相关性。
- 长期知识。 可以跨会话复用的事实、偏好、项目资料和经验,追求可发现性与更新质量。
- 行为程序。 System Prompt、技能、工具 Schema 和调用规则,决定 Agent 如何行动。
- 可迁移状态。 能被导出、审计、复制和恢复的配置与检查点,追求格式稳定性和边界清晰。
文件系统的启发在于:不同状态不必全部塞进同一个地址空间,可以通过目录、权限、版本和装载策略进行分层。但 LLM 又提出了一个经典文件系统没有的要求:内容不仅被读取,还可能被模型解释为指令。因此,“可寻址”不等于“可信”,“可恢复”也不等于“行为完全复现”。 文件路径解决的是找到什么,版本记录解决的是何时改变,安全策略和评测才解决应该不应该采用。
从工程角度看,未来更值得优先建设的不是统一一个巨大的 Agent 文件,而是统一以下元数据:来源、所有者、版本、有效期、敏感级别、可执行性、依赖模型和验证结果。这样,OpenViking 的检索、MemFS 的提交和 .af 的导入才能共享同一套治理语言。
5.5 可验证的扩展方向
可以围绕三类任务建立一个小型对照实验,而不是仅凭项目叙述判断优劣:
| 实验 | 对照 | 主要指标 | 预期观察 |
|---|---|---|---|
| 跨会话任务接续 | OpenViking、MemFS、纯 Prompt 历史 | 任务完成率、首轮 Token、错误记忆率 | 长任务中,分层记忆应降低重复阅读;错误抽取率不能显著上升 |
| Agent 迁移与恢复 | .af 导入前后、不同模型端点 |
恢复成功率、工具调用正确率、人工修复项数 | 配置和记忆可恢复,但外部依赖与模型差异会造成部分降级 |
| 并发编辑与回滚 | MemFS Git 提交、OpenViking 异步 Commit | 冲突率、丢失更新数、索引陈旧时间 | Git 更擅长发现冲突,OpenViking 更擅长集中检索;两者都需要一致性屏障 |
实验结论应分别报告检索效果、上下文成本、行为一致性和安全事件,不能只用“能否成功回答”一个指标概括。对 Agent 系统而言,真正的工程收益是让状态具有清晰的生命周期:能够找到、能够解释、能够修改、能够回滚,也能够在不可信时拒绝加载。