LLM新技术中的CS原型(四)ARTEX:双图架构解决长任务幻觉问题
LLM新技术中的CS原型(四)ARTEX:双图架构解决长任务幻觉问题
主作者:陈劲铧
本文基于 ARTEX 当前源码、本地深度拆解文档和仓库既有截图编写。实验仅限本地页面与源码测试,不连接线上 Demo,不执行真实目标探测。ARTEX 官方免责声明禁止将其用于线上系统、生产环境或未经授权的目标。
参考资料
- 官方仓库:GitHub - mhtsec/ARTEX
- Demo:ARTEX — 自主渗透测试控制台
- 深度拆解:D:/ARTEX/ARTEX/深度拆解/01-系统架构与核心机制.md、02-数据模型与执行链路.md
- 本地源码快照:D:/ARTEX/ARTEX,当前阅读提交 b55ceb1fdd84a813d77de09a06af83d323a81f85
1 项目介绍
1.1 ARTEX 要解决什么问题
普通 Agent 往往把目标、工具和历史消息交给一个模型,让它连续调用工具,最后输出一段总结。任务一长,就容易出现:
- 模型忘记目标,重复探测或偏离范围;
- 前置事实尚未出现,后续步骤已经被提前执行;
- 一个 Worker 的中间观察没有写入公共状态,其他 Worker 只能重复劳动;
- 资产、事实、漏洞和过程混在一张列表里,无法回答“这个结论从哪里来”;
- 暂停、失败或重启后,系统无法区分已完成工作和待领取工作。
ARTEX 的回答是一个由 Planner、Worker、双图数据库和工具治理层组成的长任务运行时:
- Planner 判断下一步值得探索什么,不亲自执行探测;
- Worker 领取一条意图,在授权范围内执行、写回并停止;
- 资产图保存跨任务可复用的资产真值;
- 探索图保存当前任务的目标、意图、事实、发现和血缘;
- PostgreSQL 充当共享黑板,图变化通过事件唤醒下一轮 Planner;
- Guard、Intercept、流量记录和证据快照把行动放进可审计边界。
因此,ARTEX 更像事件驱动的自主探索系统,而不是把 LLM 包在扫描器外面的聊天壳。
1.2 系统分层
1 | flowchart TB |
| 层 | 主要目录或文件 | 作用 |
|---|---|---|
| 前端 | web/ | 仪表盘、任务、资产、探索图、会话和审批 |
| API | server/server.go、server/*_api.go | REST、JWT、SSE 和文件接口 |
| 调度 | server/engine.go、server/manager.go | Planner/Worker 循环、暂停、取消和超时 |
| Agent | agent/planner.go、agent/worker.go、agent/mainagent.go | 规划、执行、人工对话和目标判断 |
| 状态 | db/、db/schema.sql | 双图、任务、活动、证据和配置 |
| 治理 | guard/、intercept/ | allow/deny/ask 和人在环路审批 |
| 观测 | traffic/、llmrec/、report/ | 流量、LLM 调用、Token、报告和证据 |
1.3 本地界面素材
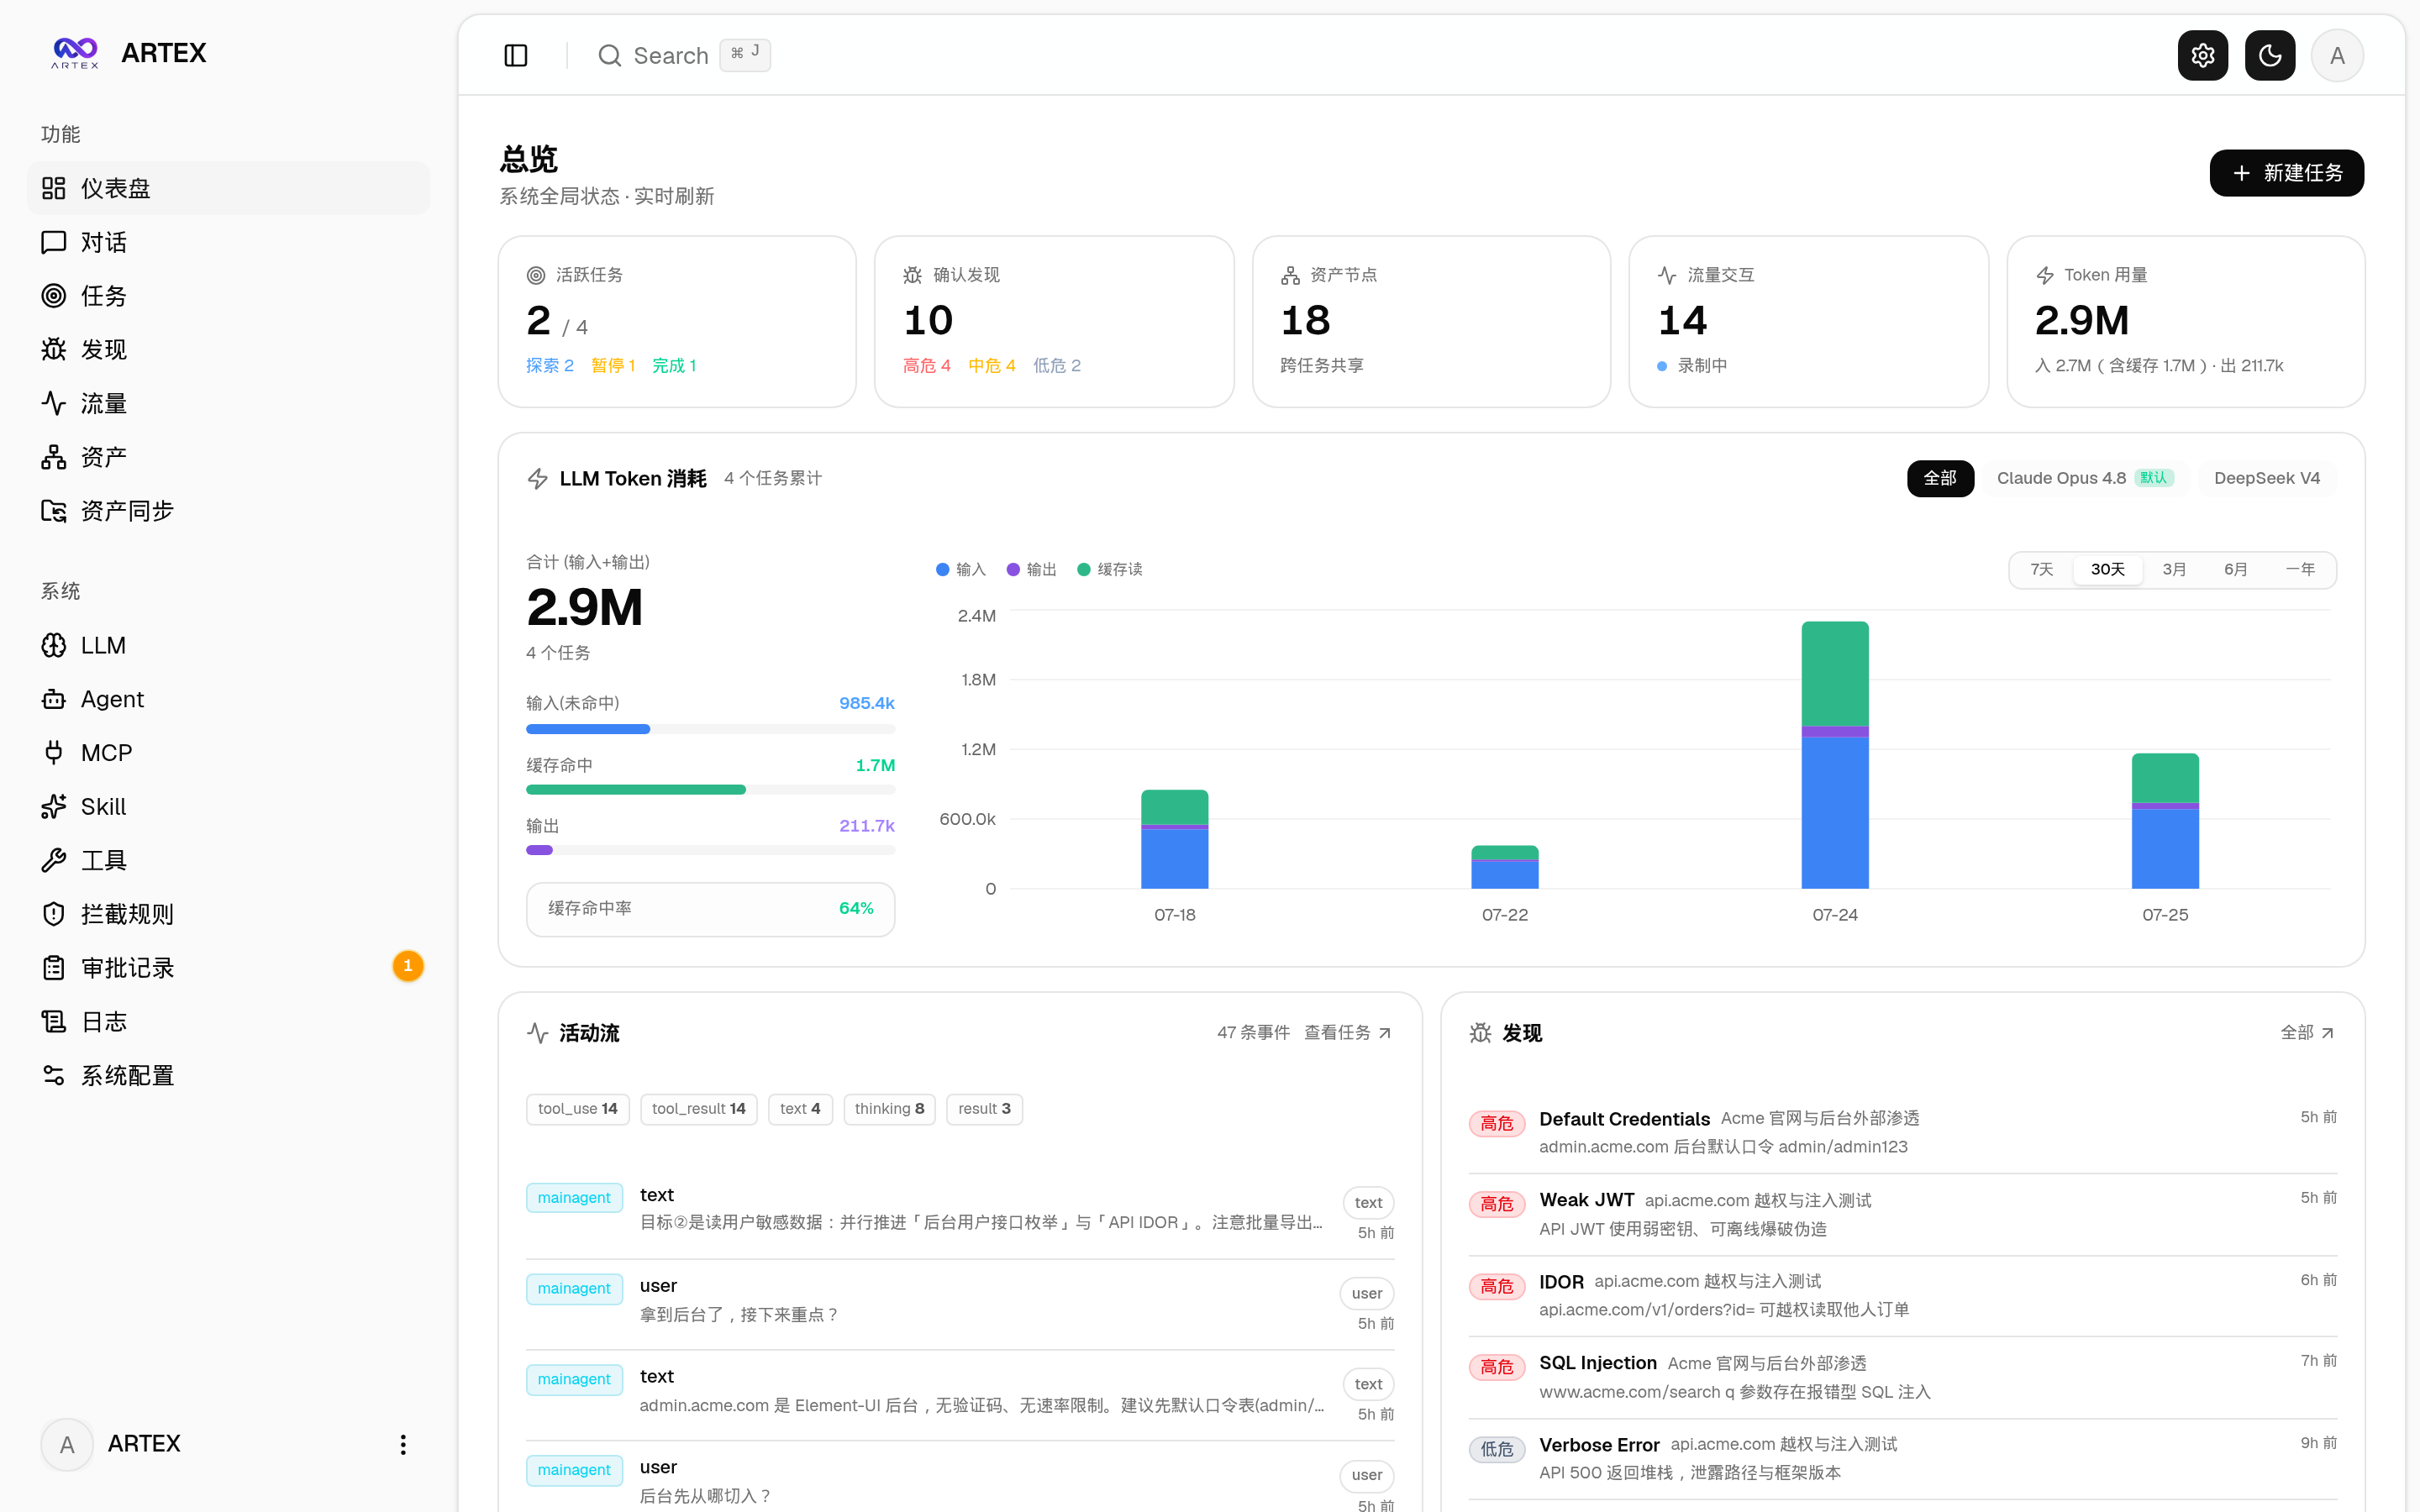
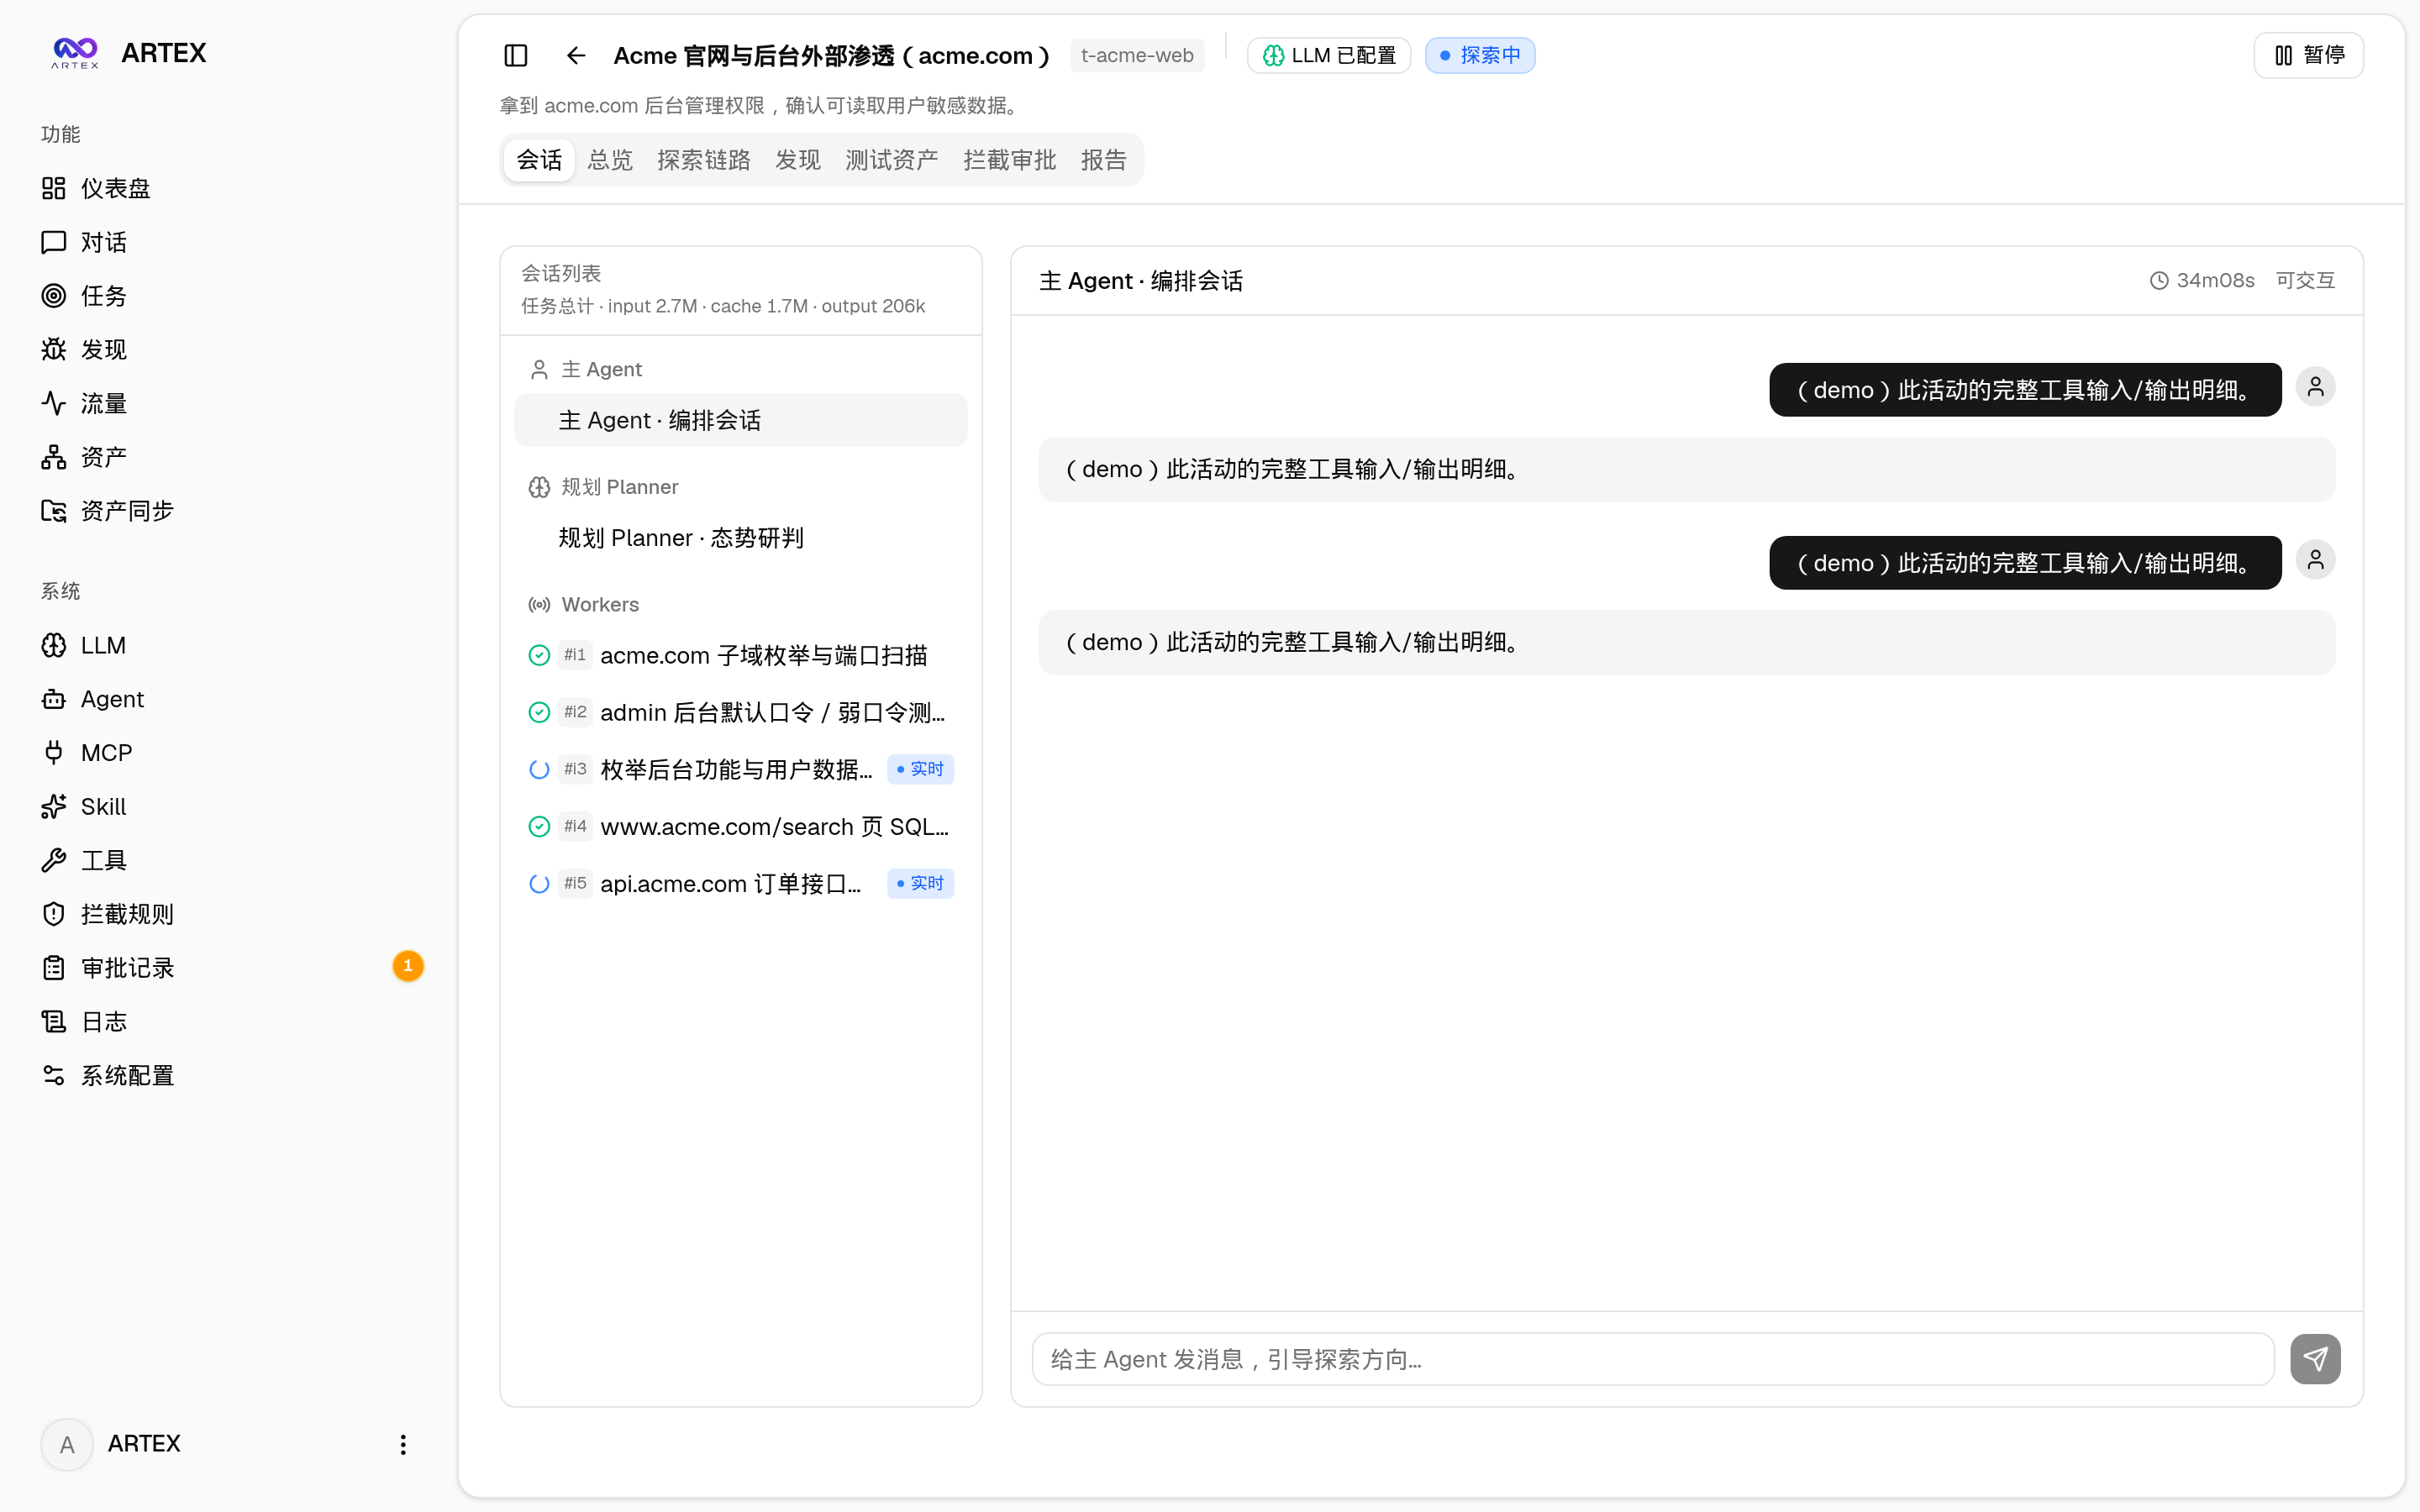
图片来自仓库既有截图,已复制到本文旁边的 assets/artex/,Typora 可以直接读取;远程发布时可替换为图床路径。
2 核心内容:双图、黑板和 Worker
2.1 资产图:世界里有什么
资产图是全局共享的资产真值库,典型节点包括:root_domain、subdomain、ip、service、app 和 endpoint。
它的关键特点是去重和归属。同一个域名被不同任务发现时,不由 Agent 自己决定是否重复创建,而是由程序根据资产类型和唯一索引归并。任务通过 task_scope、task_asset_links 表达本次允许关注的范围。
资产图表达事实对象,不是某个 Worker 的猜测。新资产由 insert_assets 写入;探索结论应写入探索图的 fact 节点,而不是塞进资产字段。
为什么资产图必须和探索图分开
如果把“某个域名存在”和“本次任务曾经验证过该域名的某个接口”写在同一张表里,会产生两个相反的问题:第一,同一资产被不同任务反复复制,资产真值无法复用;第二,删除或归档一个任务时,容易误删其他任务仍在使用的资产。ARTEX 的做法是让 assets 保存跨任务共享的对象,让 task_ids、task_scope 和 task_asset_links 表达任务关联,把本次推理过程留给 exploration_nodes。
源码中的唯一索引体现了这一取舍:根域名按 domain 去重,IP 按 ip 去重,子域名按 domain 与 record_type 去重,HTTP 服务按 url 去重,端点按 url 与 method 去重。也就是说,Agent 只提交原始资产字段,归一化和去重由数据库索引负责,避免模型决定“这是同一个资产还是新资产”。
资产写入的实际路径
Worker 调用 insert_assets 后,工具层先把资产类型和字段转换成结构化对象,再由 AssetStore 执行 upsert;成功后会把资产锚定到当前 Worker 的 intent 节点,并触发异步 DNS/HTTP enrichment。这样,资产图承担对象发现,探索图承担发现原因,二者通过 exploration_anchors 关联,而不是在一个 JSON 字段里互相嵌套。
2.2 探索图:本次任务如何得到结论
探索图是每个任务独立的推导链路。db/schema.sql 将节点类型约束为:
1 | begin / goal / intent / fact / finding / hint / digest |
边类型约束为:
1 | spawns / derived_from / yields / proves / covers |
它们表达目标产生意图、意图产生事实、事实推动下一条意图、发现证明目标的血缘关系:
1 | flowchart LR |
exploration_anchors(node_id, asset_id) 是两图之间的桥:它把探索节点锚定到真实资产,使系统可以从意图看到目标资产,也可以从资产反查本任务的探索记录和覆盖情况。
边不是装饰字段,而是 Planner 的输入
graph_overview 读取 exploration_edges,构造 parentsOf、yieldsOf 和 factFrom 三个索引:parentsOf 表示一个意图由哪些事实或上游意图派生,yieldsOf 表示一个意图产出了哪些事实/发现,factFrom 表示事实来自哪个 intent。Planner 看到的不是“事实列表”,而是“哪个方向产出了哪个事实、下一个方向依赖哪些事实”。这正是图结构相比平铺聊天记录的工程价值。
例如,record_fact 写入事实时,工具层会建立 intent --yields–> fact;add_intent 如果引用了已有事实,会建立 fact --derived_from–> intent。prove_goal 则建立 evidence --proves–> goal。关系由 Go 代码创建,而不是让模型直接填写任意 source、target 和 rel,因此可以在写入点限制关系类型和任务归属。
2.3 黑板:共享状态面,而不是第三张图
ARTEX 的黑板可以用经典 Blackboard Architecture 理解:多个知识源把观察写入共享空间,控制者根据共享空间选择下一步工作。这里没有一个单独叫 blackboard 的表,而是由以下对象共同构成:
| 黑板组成 | 保存内容 | 主要写入者 | 主要读取者 |
|---|---|---|---|
| 探索图节点与边 | 目标、意图、事实、发现及血缘 | Planner、Worker、主 Agent | Planner、Worker、UI |
| 资产图与锚点 | 资产真值、任务范围、资产关联 | Worker、资产同步流程 | Planner、Worker、覆盖视图 |
| activity | 工具调用、文本、结果、错误和过程细节 | Worker、Planner、系统 | UI、证据工具、复盘逻辑 |
| graph_overview | 面向模型的压缩态势快照 | DB 查询与工具层 | Planner、Worker |
| frontier | 尚未领取的 open 意图 | Planner 产生,Worker claim | Worker 调度器 |
黑板的价值是把短暂的模型上下文和长期任务状态分开。模型每次被唤醒可以是新会话,但它先读取同一个黑板快照;Worker 的输出不必完整塞回 Planner 上下文,只需写入结构化节点和活动记录。
graph_overview 为什么要做“有损摘要”
graph_overview 不是把整张图序列化给模型,而是按用途截断:open_intents 只取高优先级窗口,同时额外给出 frontier_open 总数;recent_done_intents 只保留最近一窗,同时给出 done_intents_total;recent_facts、finding_list、cold_digests 也分别设置上限。这样做是因为 Planner 真正需要的是“是否还有活、最近发生了什么、目标是否已满足”,而不是一次读入所有历史节点。
摘要并不删除数据。旧事实仍可通过 node_detail、list_facts 或展开 digest 查询。这个设计把热路径的上下文成本控制在固定上限,同时保留按需追溯能力;代价是模型必须知道何时主动展开详情。
2.4 Worker:一条意图,一个执行单元
agent/worker.go 明确规定:Worker 领取 ONE intent,完成这条意图,写回事实或发现,然后停止。它不是自由漫游的 Agent,也不负责生成新探索方向。
Worker 的三种写回有清晰边界:
- 资产 → insert_assets,只登记子域、服务、端点等对象;
- 事实 → record_fact,写入本次真实观察、证据和置信度;
- 确认发现 → report_finding,必须有本次真实触发并可复现的证据,不能仅凭版本号、指纹或外部漏洞库推断。
Worker 每一步还会写入 activity,因此没有正式写成 fact 的中间观察至少仍有过程记录。当前版本对 Worker 工具面做过收敛,旧博客中的工具列表不一定代表当前提交。
为什么 Worker 只领取一条意图
如果一个 Worker 同时负责资产枚举、漏洞验证、报告生成和下一步规划,模型会在同一上下文中混合多个目标,最终很难判断哪些结果属于哪条链路。ARTEX 把 intent 作为 Worker 的最小执行单元:启动时将 intent 的 summary、intent_id 和锚定资产注入系统/用户上下文;执行期间每次工具调用都带着当前 node_id;结束时只转换这一条 intent 的状态。
这是一种“上下文隔离”而不是简单的并发拆分。Worker 可以看到只读的全局态势用于去重,但不能因为看到新线索就自行创建另一条探索方向;跨意图的新线索应写进 fact,由 Planner 决定是否派生新 intent。
2.5 Planner:唯一的意图生成者
Planner 读取态势、判断目标、生成 0…N 条新意图。它不执行探测工具,也不把整条长链一次性摊开。当前提示词和工具接口要求它:
- 目标未达成且没有 open/running 意图时,必须提出至少一个推进方向;
- 前置事实尚未出现时,不派发依赖它的后续意图;
- 用 prove_goal 逐个标记已被证据证明的目标;
- 量化目标必须核对 graph_overview 中的实测值;
- 一次批量提交有限数量的高价值意图,避免 frontier 无限膨胀。
Planner 还维护一份按探索任务索引的 TodoStore,让串行计划跨唤醒继续存在。但当前实现主要在 Planner 进程内保存,不能误解成完全持久化到数据库的事务计划;重启后仍需从探索图和事实重建方向。
Planner 为什么不直接执行工具
Planner 的输出被限制为 add_intent、prove_goal、goal_met 等规划类动作。这样做有两个原因:一是把高成本、可能有副作用的工具调用集中到 Worker 和 Guard 这一条链路,二是让 Planner 每次唤醒都可以重新计算全局状态,而不会被某个长时间运行的命令占住。Planner 产生意图后立即返回,Engine 的 workerLoop 再从 frontier 领取;这使规划吞吐和执行吞吐可以独立调节。
3 双图 + 黑板的执行链路
3.1 事件驱动闭环
1 | sequenceDiagram |
Planner 不必一直占用一个超长上下文。每轮规划结束后,Worker 在后台执行;Worker 写回后再唤醒 Planner。模型的短上下文被反复刷新,任务长期状态保存在数据库黑板。
把一次闭环展开到函数级,大致是:Engine 启动任务时注册 plannerLoop 和多个 workerLoop;plannerLoop 收到 notify 或 heartbeat 后调用 Planner.Plan;Planner 通过 ToolSet.add_intent 写入 exploration_nodes,并建立与目标/事实的边;workerLoop 调用 claimNext,内部先取 Frontier,再调用 ExplorationStore.ClaimIntent;成功后进入 Worker.Execute;Execute 构造带 intent_id 的 ToolSet,调用 insert_assets、record_fact 或 report_finding;写回函数在事务中插入节点、边、锚点和 activity,最后调用 t.NotifyDone 或 notifyFinding;Engine 收到通知后重新进入 plannerLoop。
这条链把“模型输出”和“系统状态变化”分成两个阶段:模型只产生工具调用参数,Go 运行时负责校验、落库、建立关系和发事件。也正因为中间存在这个状态层,模型即使在下一轮换了上下文,仍能从数据库恢复任务,而不必依赖上一轮的自然语言记忆。
3.2 原子领取和 Worker 生命周期
db/exploration.go 的 ClaimIntent 将意图从 open 原子转为 running。多个 goroutine 同时看到同一条 frontier 时,只有一个 Worker 能成功领取。
具体流程是:workerLoop 先读取 Frontier(20) 得到按 priority DESC、id ASC 排序的候选窗口;随后逐个调用 ClaimIntent。ClaimIntent 使用“只有当前 state=open 才更新为 running”的条件更新,成功的 Worker 获得 owner,失败者继续尝试下一候选。这里故意没有把“读 frontier”和“改状态”做成普通两步逻辑,否则两个 goroutine 都可能读到同一条 open 意图并重复执行。
任务启动时也不会盲目唤醒 Planner。Engine 会先检查 HasActiveIntent;只要存在 open 或 running 意图,就让 Worker 直接工作,避免“Worker 已经抢到意图、Planner 又额外跑一轮”的竞态。Worker 完成后调用 NotifyDone,Engine 再唤醒 Planner。
暂停、取消和超时也通过 CompareAndSetIntentState 进入状态机:暂停中的 running 意图回到 open,恢复后可以重新领取;任务级超时通常进入 exhausted,保留已经写回的事实;Planner 主动 kill 的工作进入 stopped,不再自动重领。这样,状态并不是模型输出的一句话,而是由引擎在上下文取消后根据原因落库。
| 状态 | 语义 |
|---|---|
| done | 正常执行结束并写回结果 |
| blocked | 执行出现错误,暂时无法完成 |
| exhausted | 达到步数或时间预算,已执行部分保留 |
| paused / open | 用户暂停或可恢复的中断 |
| stopped | 任务完成、被取消或被 Planner 终止 |
3.3 黑板如何降低长任务幻觉
ARTEX 不会消除模型幻觉,而是用结构约束降低错误影响:目标和验收条件每轮重新读取;事实和已结束方向写回图用于去重;fact→intent 边保存前后依赖;report_finding 要求真实证据;graph_overview 压缩上下文;Worker 只做一条意图,Planner 与工具审批分别承担规划和治理。
它把“模型必须一直记得所有事情”改写成“系统必须让关键状态可重新读取、可追溯、可校验”。
4 源码证据与数据模型
4.1 Schema:节点和边不是自由文本
db/schema.sql 对探索图做了最小形式化:
1 | kind CHECK (kind IN ('begin','goal','intent','fact','finding','hint','digest')) |
这不是完整知识图谱推理器,但它让 UI、查询和 Planner 拥有稳定类型集合。资产图则通过不同资产类型的唯一索引去重。
4.2 Tool:模型只能通过接口改变黑板
agent/tools.go 对模型暴露 graph_overview、add_intent、record_fact、report_finding、prove_goal 等工具。模型可以提出结构化写入,但最终写入仍由 Go 代码校验、建立边、绑定资产和触发通知,模型不能直接执行任意 SQL 修改探索图。
record_fact 的合理最小形态类似:
1 | { |
confidence 不是经过校准的数学概率,而是区分直接观察和推断的工程标签。inferred 不能直接当成已证明漏洞。
写回接口还承担了“结论粒度控制”。Worker 提示词要求一次意图的多个观察尽量合并成一条 fact,用 summary 保存可检索的一句话,用 detail 放细节,用 evidence 保存最小可核验片段;只有彼此独立、无法合并的结论才使用 facts 数组。这样做是为了防止每个状态码、标题和指纹都成为一个节点,导致探索图膨胀、Planner 每轮读到大量重复信息。
report_finding 比 record_fact 更严格:它要求漏洞类别、严重性、受影响资产、summary 和证据/PoC,并把 finding 记录同时落到 findings 业务表和探索图 finding 节点。版本匹配、CVE 查询或“看起来可注入”只能写成 inferred fact,不能直接生成 confirmed finding。这是把“模型判断”和“系统承认漏洞”分开的证据门。
4.3 activity:状态之外的过程日志
探索图适合表达压缩后的知识,activity 适合表达工具调用、模型文本、错误、结果、Token 和流量关联:
1 | activity = 过程证据(可复盘) |
只保存 fact 会丢掉为什么得到这个事实;只保存 activity 又会让 Planner 每轮重新理解全部长日志。ARTEX 用双层表示在上下文成本和可追溯性之间折中。
4.4 Guard、Intercept 与流量证据:为什么工具调用还要再过一层
Worker 看到的工具并不是直接连接目标的裸函数。执行链在工具调用前进入任务上下文和 Guard:允许的调用继续执行,被规则拒绝的调用只记录拒绝原因,需要人工决定的调用进入 intercept_pending,等待人在环路做 allow 或 deny。这样做的原因是,模型的“我应该执行这条命令”不能等价于系统的“这条命令有权执行”。
源码中任务约束以 task_constraints 表保存 allow/deny 文本,并在 Planner 和 Worker 的系统提示中注入;资产拦截规则还会在 add_intent 和 insert_assets 前检查目标资产。两层检查分别处理“操作类型是否允许”和“目标资产是否允许”,避免只在工具执行后才发现越界。
对 HTTP/HTTPS 工具,traffic 代理负责记录请求、响应和时间线,必要时生成 traffic evidence snapshot。report_finding 可以绑定这些 traffic_refs,使漏洞结论不仅有模型写出的 PoC 文本,还有可回放的请求/响应证据。代理、Guard 和探索图因此形成三条不同的记录:Guard 说明“是否允许”,traffic 说明“实际发生了什么”,finding 说明“系统最终承认了什么”。
4.5 为什么使用 PostgreSQL,而不是只用向量库或 JSON 文件
ARTEX 的关键操作都需要事务和条件更新:创建节点与边要保持同一任务归属,ClaimIntent 要避免双领,finding 写入要同时更新业务表和探索节点,删除意图还要处理血缘和资产锚点。PostgreSQL 提供外键、CHECK、唯一索引、JSONB、数组字段和事务,能够把这些不变量交给数据库执行。
向量库适合“找相似内容”,却不能天然表达“只有 state=open 才能转换为 running”或“这条 finding 必须属于同一个 exploration”。JSON 文件也难以在多个 Worker 并发写入时提供可靠的行级条件更新。因此 ARTEX 选择关系数据库承载图的物理存储,再由 Go 查询层把关系表投影成 Planner 可读的图概览。
5 自测与源码实验
5.1 实验边界
本节只报告本机能够复核的内容:源码阅读、http://localhost:8787 页面可达性、Go 包测试和既有界面截图。不连接线上 Demo,不执行真实目标探测,不把新闻报道中的数据当成本机结果。
5.2 本地页面可达
1 | Invoke-WebRequest -Uri http://localhost:8787 -UseBasicParsing |
本机结果:HTTP 200,返回页面内容约 14 KB。这只证明存在可访问的 Web 服务,不能据此推断 PostgreSQL、LLM、流量代理或探索任务已经可用。
5.3 db/agent 包测试
1 | Set-Location D:\ARTEX\ARTEX |
本机结果:db 和 agent 均返回 ok。这支持有限结论:探索节点、边、事实、发现、意图控制和 Agent 工具装配代码具备可编译并通过已有测试的路径;ClaimIntent 的原子领取和状态控制有对应测试。
它不能证明真实模型会正确选择工具,也不能证明所有工具在 Windows 上可运行。
从测试对象看,这不是一个只有提示词的项目:db 包测试节点/边写入、事实与发现血缘、意图状态转移和并发领取;agent 包测试 ToolSet、Planner/Worker 的提示装配以及空转、重试、写回等运行分支。测试通过说明“状态机和写回协议能按预期运行”,不等于“模型一定会选出正确意图”。
5.4 server 包测试暴露的边界
1 | go test ./server |
本机没有全绿,失败原因包括:多个端到端测试需要 ARTEX_PG_DSN 或 server/config.json 中的 PostgreSQL 配置;TestExecPython 在 Windows 环境下找不到预期 Python 命令;部分路径测试按 Unix 风格路径断言,与 Windows 分隔符不同。
因此应准确表述为:核心 db/agent 测试通过,依赖 PostgreSQL、外部工具链或 Unix 语义的 server 测试未完成;不是完整测试通过。
5.5 界面图片复盘
仓库已有 graph.png、sessions.png、findings.png 和 dashboard.png,可以验证产品界面围绕任务执行过程、探索链路、发现证据和活动总览组织。
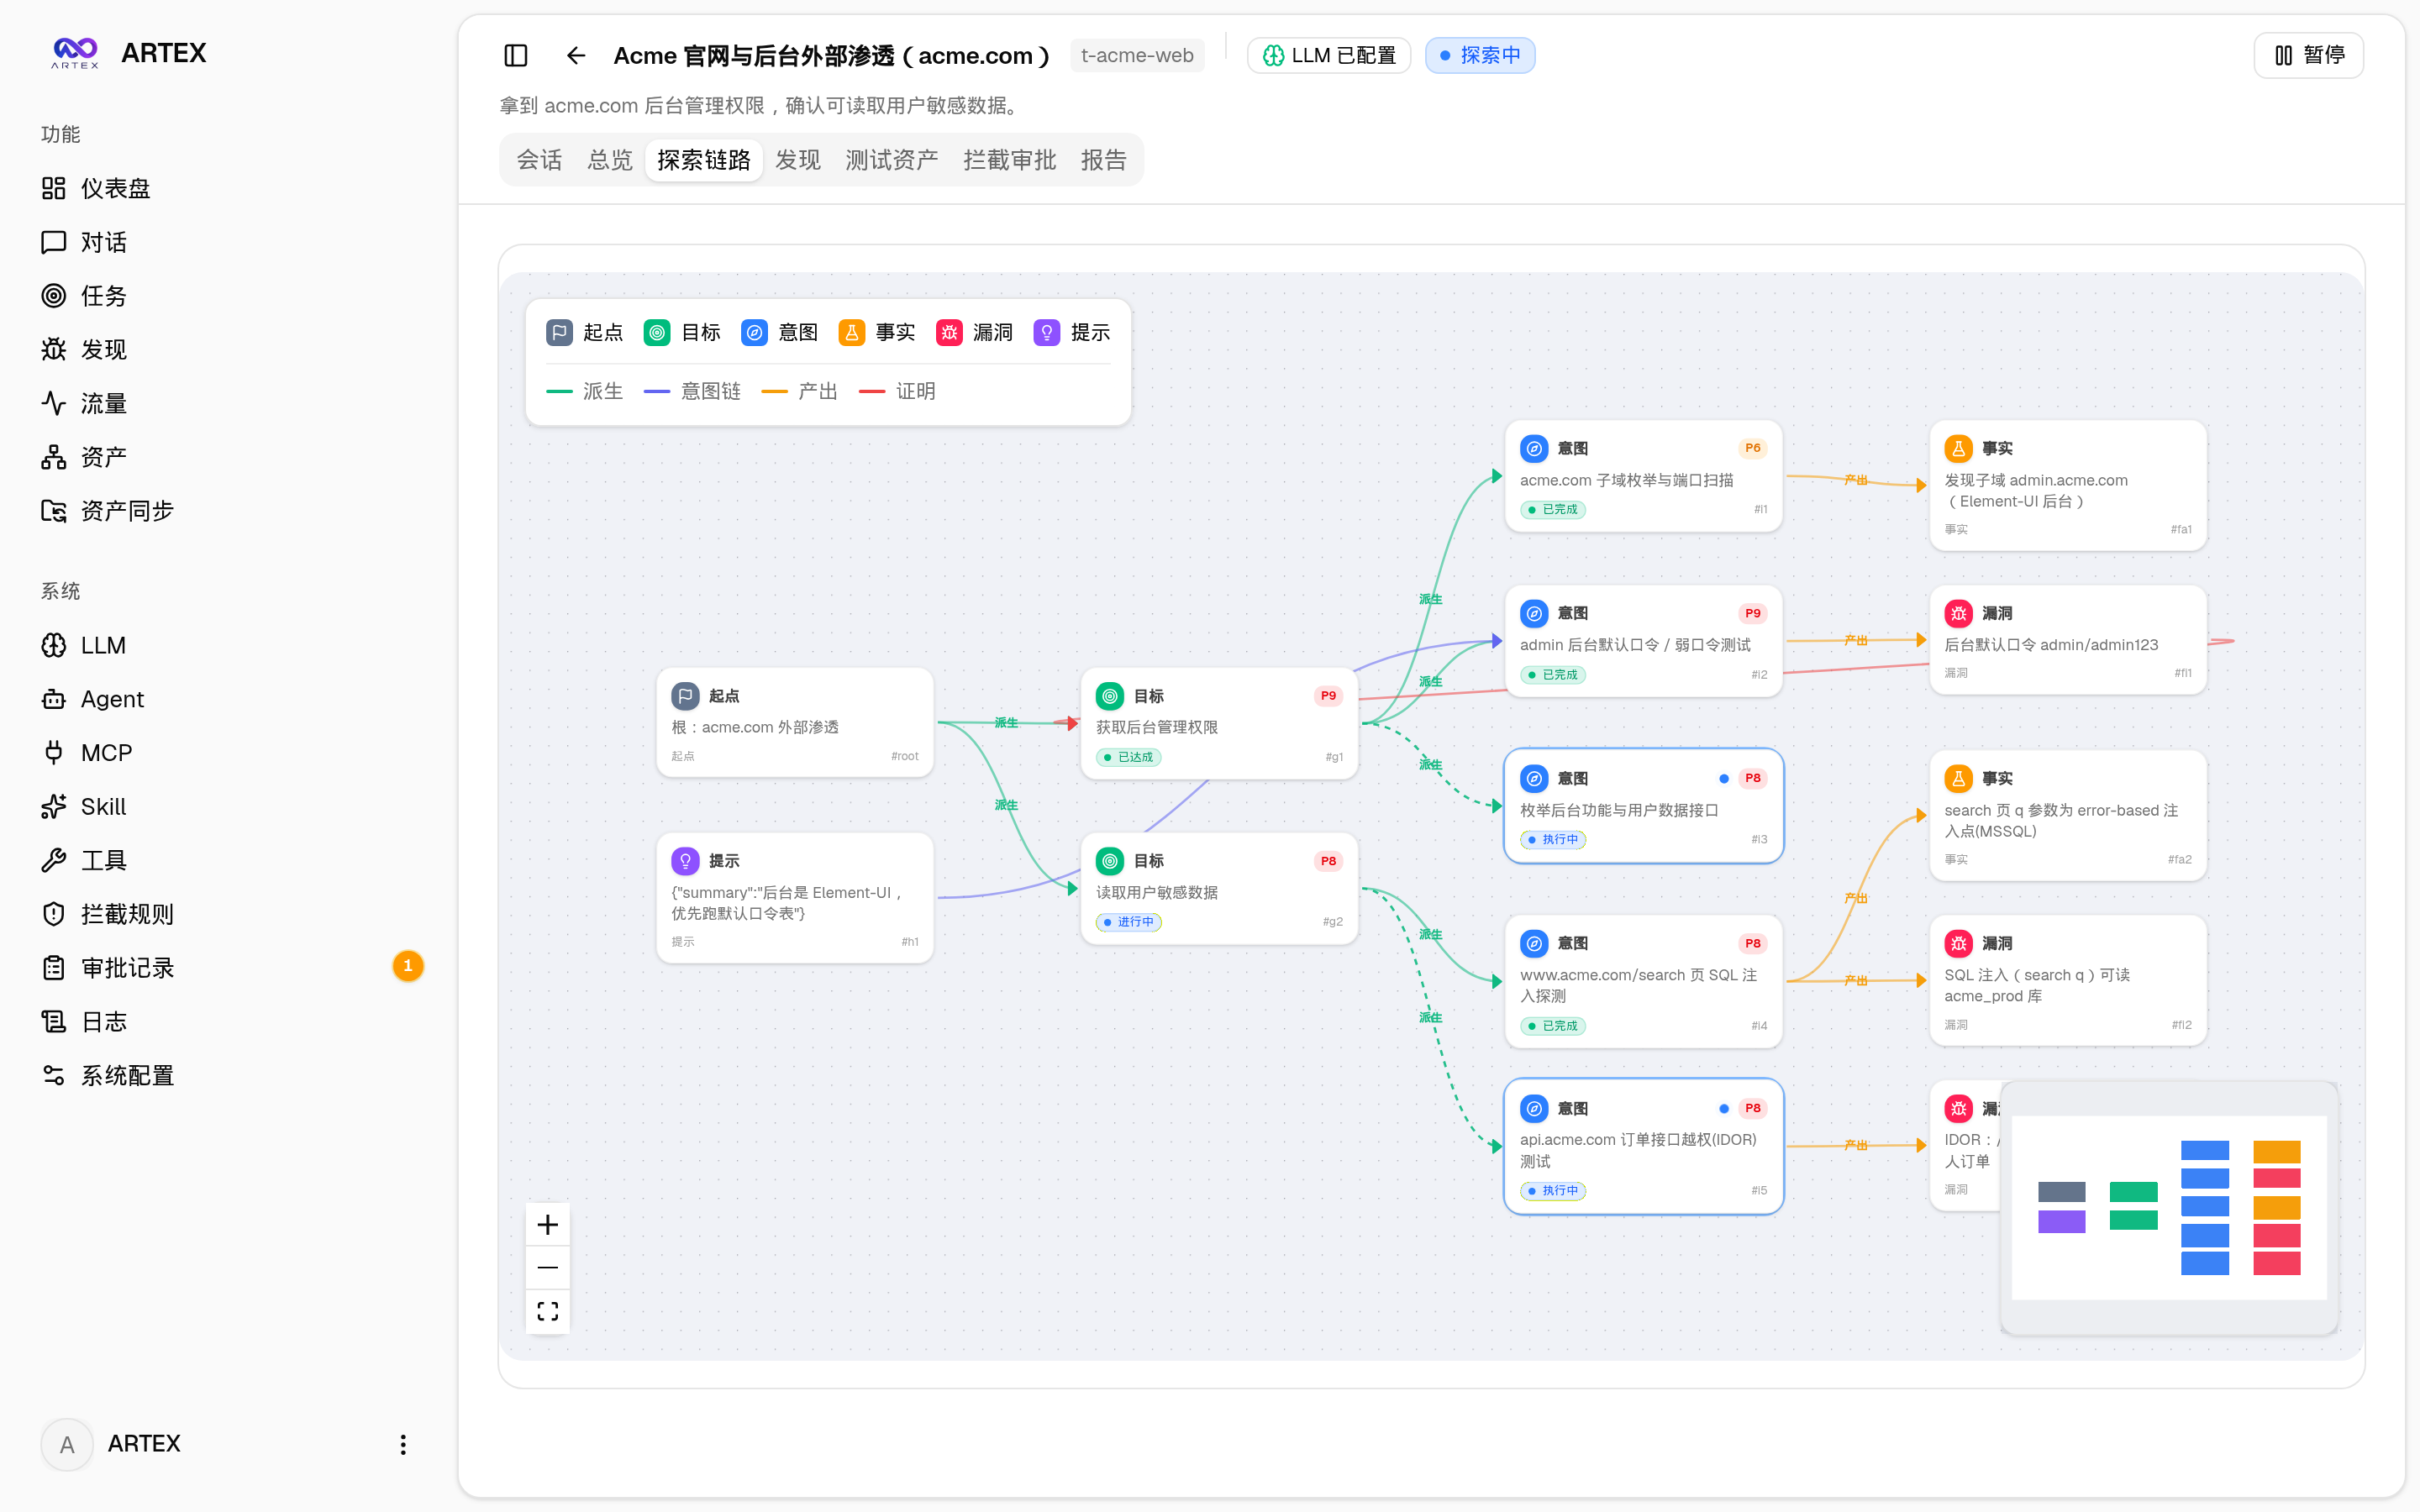

这些图片是产品界面证据,不是一次新任务的测量数据;不能据此推导扫描覆盖率、漏洞数量或模型成功率。
6 主要优点与主要缺点
6.1 主要优点
- 双图分离资产真值和探索血缘。 同一资产可被多个任务复用,而每个任务的推导链互不污染。
- 黑板支持长任务断点续跑。 Planner 不必持有永不结束的上下文,Worker 的关键结果写入数据库后即可被下一轮读取。
- Planner/Worker 职责清晰。 Planner 负责方向,Worker 负责一条意图,并发执行和串行依赖由不同层处理。
- 图边让“为什么这样做”可解释。 spawns、yields、derived_from、proves 可以重建任务证据链。
- 工具写回结构化。 资产、事实、发现、目标证明分属不同接口,便于去重、报告和复测。
- 治理和观测在执行链中。 Guard/Intercept 可让危险操作进入 deny 或人工 ask;activity、LLM records 和 evidence snapshots 支持复盘。
- 经典 CS 原型清晰。 黑板架构、工作队列、状态机、事件日志和知识图谱都能找到具体代码落点。
6.2 主要缺点与风险
- 双图不自动保证事实正确。 Worker 写入错误事实后,Planner 仍可能在错误黑板上继续规划。
- TodoStore 不是完整持久化事务计划。 它主要驻留 Planner 进程内,重启后需要从图和事实重建。
- 摘要会丢细节。 graph_overview 面向模型压缩,若模型不主动查询详情,可能忽略旧事实中的限制。
- 并发提高协调复杂度。 相近意图可能重复,Planner 需要去重和合并。
- 成本和延迟仍会累积。 Planner 唤醒、Worker 工具、重试、压缩和复测都可能消耗 Token 与外部资源。
- 数据库是关键依赖。 PostgreSQL 不可用时,页面可能仍能打开,但黑板、证据和任务状态无法可靠推进。
- 安全不能只靠提示词。 工具审批、资产范围、命令隔离、网络限制和凭据保护必须由代码、容器和权限系统共同执行。
- 平台差异明显。 部分工具和测试以 Linux/Kali 习惯为前提,Windows 本地验证可能失败。
- 源码变化较快。 旧博客描述的 Worker 工具集、跨 work 检索或图压缩可能已经变化,应以当前提交和 CHANGELOG.md 为准。
7 迁移解剖:从经典 CS 到 ARTEX
这一节不把“黑板”“图”“队列”当作装饰性比喻,而是沿着“原型解决什么问题 → ARTEX 保留了什么机制 → 源码如何落地 → 迁移后牺牲了什么”的顺序逐项解剖。这样才能区分三种不同层次的借鉴:
- 概念迁移:借用一个成熟原型的解释框架,例如把 Planner/Worker 的共享状态称为黑板。
- 结构迁移:把原型中的数据结构直接落到表、索引、边和状态字段,例如
exploration_nodes、exploration_edges、activity。 - 控制迁移:把原型中的并发、事件、恢复和不变量带进运行时,例如
ClaimIntent的单赢家领取、CompareAndSetIntentState的条件更新和 Planner 的心跳唤醒。
判断一次迁移是否“真的成立”,至少要回答五个问题:经典系统原来消除了哪一种失控;ARTEX 取用了哪些数据结构和控制流;哪些不变量由数据库/Go 代码保证;哪些部分仍交给 LLM;迁移之后引入了什么新的代价。ARTEX 的价值,恰恰在于它没有把所有责任都继续压给 Prompt,而是把可判定的部分移到持久化系统。
7.1 黑板架构:从专家共享工作区到 Agent 共享状态面
7.1.1 经典黑板解决的原问题
经典黑板系统(blackboard architecture)面对的是:问题不能由一条固定流程解决,多个“知识源”掌握不同技能,需要根据当前中间结果动态选择下一步知识源。它通常包含三个部件:
- 黑板(blackboard):保存当前问题状态、中间假设和已确认结果;
- 知识源(knowledge sources):只在自己关心的状态出现时被激活,并向黑板贡献结果;
- 控制器(control component):观察黑板变化,选择下一次激活哪些知识源。
关键不在“大家都能读写一张表”,而在于:知识源之间不需要共享完整会话,只需要围绕一个公共状态面协作。一个知识源失败时,控制器仍可以选择另一个知识源继续推进。
7.1.2 ARTEX 的对应关系
| 经典黑板部件 | ARTEX 的具体实现 | 迁移含义 |
|---|---|---|
| 黑板 | PostgreSQL 中的探索图、资产图、activity、frontier、graph_overview |
状态从 Prompt 迁移到可查询、可审计的持久化面 |
| 知识源 | Planner、多个 Worker、目标拆解器、主 Agent、证据/复测工具 | 不同 Agent 通过写入不同节点类型协作,而不是互相复制长上下文 |
| 控制器 | server.Engine 的 plannerLoop、workerLoop 和通知通道 |
用事件和心跳选择何时重新规划、何时领取意图 |
| 激活条件 | 新增目标、add_intent、Worker 完成、report_finding、NotifyDone |
黑板变化转化为下一轮规划触发器 |
| 终止条件 | prove_goal 使目标满足,或 frontier 与 running 意图均为空 |
由结构化状态判断收敛,而不是由模型一句“完成了”判断 |
这属于架构级迁移:ARTEX 同时迁移了共享状态、知识源分工、事件唤醒和收敛判定。不过它没有照搬传统系统的“规则触发器集合”。传统黑板往往由人工编写的启发式规则选知识源,ARTEX 则让 Planner 在 graph_overview 和工具约束下生成下一批 intent,所以控制策略仍具有概率性。
7.1.3 黑板在源码中的一次完整写回
一次 Worker 执行并不是把整段对话发给下一个 Worker,而是沿着下面的链路更新黑板:
1 | Worker 领取 intent |
这里有一个重要的工程取舍:NotifyDone 只负责“有状态变化,请重新看一眼”,并不把完整结果塞进通知消息。Planner 被唤醒后重新从数据库读取状态,避免通知通道变成第二份容易过期的事实来源。通知是边沿信号,数据库才是权威状态。
7.1.4 为什么 LLM 系统需要黑板化
单个长对话把历史、计划、工具回显和结论全部压在上下文窗口中,至少有四种风险:
- 容量风险:工具输出不断增长,模型被迫压缩或遗忘早期事实;
- 角色污染:规划、执行、审计和自然语言解释混在同一段对话中,模型容易把“计划”误当成“已完成”;
- 并发风险:两个 Worker 无法可靠地从同一份 Prompt 判断谁已经领取了任务;
- 恢复风险:进程重启后,内存里的中间状态和未完成动作难以准确恢复。
黑板化之后,Planner 只看当前任务视图,Worker 只处理一条 intent,审计信息落在 activity 和证据记录中。模型可以更换、Worker 可以重启,长期状态仍然存在。
7.1.5 迁移后保留与牺牲
保留的是“围绕共享中间状态进行机会式协作”;牺牲的是传统黑板的确定性知识源。ARTEX 的黑板内容可能包含模型生成的错误事实,因此必须附带 confidence、证据引用、来源节点和工具回显。黑板不再等于真相,而是“带来源和不确定度的工作状态”。此外,Planner 读取的是 graph_overview 的有损视图,而不是完整黑板;这换来了可控 Token 成本,也引入了摘要过期和截断风险。
7.2 双图结构:从知识图谱与工作流图到任务血缘图
7.2.1 为什么不能把两张图合成一张
ARTEX 的两张图分别回答不同问题:
- **资产图(asset graph)**回答“系统中有哪些可复用对象,以及它们的实体属性是什么”。节点是域名、IP、子域、HTTP 服务、endpoint 等资产,强调归一化、唯一性和跨任务复用。
- **探索图(exploration graph)**回答“本次任务提出了什么目标、派生了哪些意图、观察到什么事实、哪些发现由哪些证据支持”。节点是
begin/goal/intent/fact/finding/hint/digest,强调过程血缘和结论可追溯。
如果合并,资产的长期身份会被某一次任务的临时推理污染;反过来,任务中的两个相似观察又会被错误合并成同一个全局实体。分图让“对象身份”和“本次推理”拥有不同生命周期。
7.2.2 资产图:实体归一化而不是简单列表
assets 表不是 Worker 的临时输出缓存,而是一个带唯一键和派生关系的实体层。源码中的 upsert 按资产类型使用不同归一化键:根域名按 domain,IP 按 ip,子域按 domain + record_type,HTTP 服务按 url,endpoint 按 url + method。因此两个 Worker 同时发现同一服务时,数据库可以合并属性,而不是产生两个语义相同的节点。
资产写入还会触发 enrichment:HTTP 服务可以反向补充 IP 的端口信息,域名和 IP 之间保留绑定关系,任务范围通过 task_scope 与 task_asset_links 限制可见资产。这里迁移的是“事实实体库 + 归一化索引”的思想,而不是完整知识图谱本体。ARTEX 没有试图自动证明“两个字符串在语义上必然相同”,而是把可判定的唯一键交给 PostgreSQL。
7.2.3 探索图:把推理过程变成可追溯血缘
探索图的节点类型和边类型是受约束的:
| 节点/边 | 含义 | 典型写入路径 |
|---|---|---|
goal |
任务要证明或完成的结果 | 目标拆解、set_goals |
intent |
可由一个 Worker 独立执行的原子方向 | Planner 的 add_intent |
fact |
工具观察或结构化事实 | Worker 的 record_fact |
finding |
面向目标的候选发现/结论 | report_finding |
spawns |
上游目标/意图派生下游意图 | Planner 拆解 |
derived_from |
事实/发现来自哪个意图或事实 | Worker 写回 |
yields |
意图产生某个事实或发现 | 执行结果写回 |
proves |
证据或发现支持目标 | prove_goal |
covers |
digest 覆盖冷节点 | 压缩/归档流程 |
exploration_anchors(node_id, asset_id) 是两图之间的桥:同一条 intent 可以锚定多个资产,同一资产也可以被多个意图、事实和发现引用。Planner 由此知道“下一步探索什么”,资产视图则知道“这个对象在本任务中被哪些动作覆盖过”。
7.2.4 graph_overview 是图到模型视图的投影
LLM 不适合每轮读取整张图,因此 graph_overview 在 Go 层构造一个有限窗口:保留 open_intents、frontier_open、最近完成意图、总完成数、最近事实、finding 列表和 cold digest。实现上会先建立 parentsOf、yieldsOf、factFrom 等邻接索引,再把节点投影成 Planner 可理解的摘要。
这类似数据库物化视图和操作系统工作集:热节点保留细节,冷节点只保留摘要;需要时再通过 node_detail、get_worker_output 等工具按需展开。压缩不是删除,原始节点、边和 activity 仍在数据库中;因此错误摘要可以被追溯,Planner 也可以在发现冲突时回读详情。
7.2.5 没有迁移的部分
ARTEX 没有完整迁移知识图谱的本体推理、规则闭包和全局一致性证明。rel='proves' 的语义由工具参数、Go 校验和 Planner 提示词共同解释,模型仍可能把“相关”写成“证明”。数据库保证节点存在、边类型合法、外键和唯一键成立,但不能仅凭 Schema 判断自然语言结论是否正确。因此“图结构降低幻觉”并不等于“图自动产生真理”,它只是让每个结论必须挂在可追溯的节点和证据上。
7.3 工作队列、状态机与并发控制:把“下一步”变成可恢复操作
7.3.1 frontier 不是待办文本,而是可竞争消费的队列
Planner 通过 add_intent 把下一步写成 exploration_nodes(kind='intent', state='open')。这一组 open 意图就是 frontier。Worker 不从 Planner 的自然语言回复中解析任务,而是调用 claimNext,最终进入 ExplorationStore.ClaimIntent:在数据库条件更新中把一个 open 节点原子地改成 running,同时写入 owner。
并发时只有一个 Worker 能成功完成这次条件更新,其他 Worker 要么领取下一条,要么看到没有可领取意图。这个不变量比“在 Prompt 中告诉模型不要重复做”可靠得多。
7.3.2 状态不是标签,而是恢复协议
ARTEX 对 intent 的状态约束在 schema.sql 中明确列出:
1 | open |
done 表示该方向已经收尾,不表示整个目标已证明;blocked 表示执行遇到错误或策略阻断,需要 Planner 换策略;exhausted 表示预算耗尽,不能被误当作成功;paused 保留可恢复性;stopped 表示外部控制主动终止,通常不自动重放;deleted 通过软删除保留用户意图和删除原因。状态差异让 Planner 能区分“换角度”“继续”“恢复”和“不要再跑”。
7.3.3 CompareAndSetIntentState 防止竞态覆盖
所有关键收尾都使用“期望旧状态”的条件更新:只有当节点仍是 running 时,暂停、终止或正常完成才能写入对应终态。如果 Worker 收尾和用户暂停同时发生,其中一方先改变状态,另一方的 CAS 会失败,不会把新的状态静默覆盖掉。启动时 HasActiveIntent 同时检查 open + running,避免 Worker 刚把种子意图从 open 改成 running 时,Engine 又错误地启动一轮重复 Planner。
这对应分布式系统中的乐观并发控制,而不是简单的内存锁。内存中的 started、paused 和 work map 负责进程内协调,数据库状态负责重启后的最终判定,两者共同覆盖“claim → Execute → settle”窗口。
源码中的两个关键更新都很短,但它们承担了整个并发语义。领取操作的核心条件是:
1 | UPDATE exploration_nodes |
RowsAffected = 1 才算领取成功;RowsAffected = 0 不是异常,而是说明另一个 Worker 已经赢得竞争,或者该意图已被暂停/删除。收尾操作同样要求旧状态匹配:
1 | UPDATE exploration_nodes |
这两个条件更新把“谁拥有动作”和“谁有权结束动作”从模型行为变成数据库不变量。即使两个 goroutine 同时回调,也不会同时完成同一条 intent。
7.3.4 Worker 池与单意图边界
Engine 启动一个 Planner loop 和若干 Worker loop。每个 Worker 一次只执行一条 intent,intent_id 会贯穿系统提示、工具调用、activity、写回和最终状态。这样做牺牲了单个 Agent 连续跨多个方向自由游走的灵活性,却换来三个收益:
- 失败可以定位到一条意图,而不是一整段长对话;
- 同一 frontier 可以被多个 Worker 并行消费;
- 暂停、重试和 Token 统计都有清晰边界。
Worker 的自然语言输出不能直接决定状态。runIntent 根据 err、ReasonMaxTurns、ReasonTimeout、任务取消原因和终端状态进行分流,最后才调用状态迁移。模型说“我完成了”只是候选信号,程序收尾才是权威。
需要特别区分三个容易混淆的边界:
- 任务级暂停会取消执行上下文,但把正在运行的 intent 回退为
open,恢复后可以再次领取; - **Planner 的
kill_work**只停止指定 intent,并落为stopped,不会把它伪装成自然完成; - 任务级超时进入 settling 流程,正在收尾的 intent 落为
exhausted,防止超时被误报为blocked。
这种细分正是经典状态机迁移的工程实质:状态名不是 UI 标签,而是决定下一次调度和恢复动作的协议。
7.4 事件驱动与无状态 Planner:把长期记忆移出 Prompt
7.4.1 触发器、去抖和心跳
Engine 不让 Planner 以固定长会话持续思考,而是通过三类机制唤醒它:
- 边沿事件:Worker 完成、finding 写回、用户新增目标、恢复或终止动作后调用
Notify/NotifyDone; - 去抖窗口:
plannerLoop收到一批快速事件后等待短暂 debounce,把多个写回合并成一轮规划,避免每个事实都触发一次 LLM; - 心跳:即使没有新事件,也按任务配置周期唤醒,兜底处理丢失通知、飞行中的 Worker 和死锁检查。
Planner 每轮重新读取数据库快照,因此它可以是逻辑无状态的:本轮模型换了、进程重启了、上下文压缩了,都不影响长期状态的来源。Prompt 只承载当前 graph_overview、约束和本轮触发器,而不是充当数据库。
7.4.2 为什么比一个永不结束的对话可靠
一个永久对话需要模型自己记住:哪些意图已领取、哪些事实已写回、哪些方向失败过、哪个结论缺证据。ARTEX 把这些问题拆开:数据库保存事实,队列保存可执行意图,activity 保存过程,Engine 保存调度;模型只在被唤醒时做一次局部决策。这样降低了上下文漂移,但代价是事件与状态可能短暂不一致:通知可能重复、服务可能在写回后尚未唤醒 Planner、旧事件可能在恢复时再次到达。因此每轮都必须重新读状态,写入和工具要尽量幂等,不能把通知消息当作真相。
7.5 activity 与事件溯源:把过程和结论分开保存
activity 不是普通的“打印日志”。它记录 exploration_id、node_id、worker、kind、tool、tool_use_id、错误标记、摘要、详情、metadata 以及输入/输出/缓存 Token。其设计把两类信息分开:
- 过程证据:调用了哪个工具、参数是什么、返回是否报错、消耗了多少 Token;
- 结构结论:最终产生的 fact、finding、goal 状态和图边。
分离之后,UI 可以按时间线展示过程,Planner 可以按图查询结论,审计者可以把 finding 追溯到具体工具调用。删除或取消意图时,源码还会按日期汇总 Token,避免删除活动明细后计量完全丢失。这接近事件日志/Trace 的思想,但不是严格事件溯源:外部目标会变化,LLM 具有随机性,工具输出也可能失效,所以 ARTEX 保存了重查所需的证据,却不承诺可以逐字重放原任务。
7.6 Guard、Intercept 与证据门:把安全原型迁移到工具边界
经典权限系统和 Capability/Sandbox 的共同原则是:安全检查必须发生在动作真正执行之前,不能只写在说明文档里。ARTEX 将这一原则拆成三层:
- 任务约束层:
task_constraints保存操作员编辑的 allow/deny 规则,并在每轮 Planner/Worker 提示和工具调用前注入; - 执行拦截层:Guard 检查命令、资产和敏感操作;需要人工决定时写入
intercept_pending,记录工具名、输入、原因、决策来源和审计 JSON; - 证据记录层:traffic proxy 保存请求/响应引用,
activity保存调用轨迹,finding 只能引用已经存在的观察和证据。
这种迁移保留了“策略与执行分离”的架构,却没有假设模型会自觉遵守规则。即使 Prompt 被模型误读,Guard 仍可拒绝工具调用;即使工具返回了一个看似合理的结论,report_finding 也应区分 confirmed 与 inferred,不能让无证据推断直接变成已确认发现。当前实现仍不是形式化沙箱:策略覆盖范围取决于工具适配器,外部副作用和敏感数据还需要部署者配置最小权限与人工复核。
7.7 上下文压缩:从“删历史”迁移为可逆工作集
长任务无法把所有节点原样塞给每一轮 Planner。ARTEX 的 graph_overview 和 cold digest 采取“有损摘要 + 按需详情”的路线:frontier 和 running 意图优先保留,最近完成意图、事实和 finding 设窗口上限,长期不再影响活跃分支的节点进入 digest,并通过 covers 边保留覆盖关系。
这同时借鉴了数据库物化视图、操作系统工作集和缓存层:模型看到的是当前热集,原始数据仍可按 node_id 回读。代价是摘要可能遗漏细节或暂时过期,因此 Planner 在形成高风险结论前应调用详情工具,而不是把摘要当成最终证据。压缩解决的是上下文成本,不是事实正确性;摘要错误仍需通过原始 activity、工具输出和人工复核纠正。
7.8 迁移深度总表
| 经典 CS 原型 | ARTEX 具体机制 | 源码/数据位置 | 迁移深度 | 主要收益 | 主要代价 |
|---|---|---|---|---|---|
| 黑板架构 | DB 黑板、通知、Planner/Worker 分工 | server/engine.go、agent/tools.go |
架构迁移 | 长任务共享状态、模型可替换 | 黑板内容可能不正确,需证据和置信度 |
| 知识图谱/实体库 | assets、唯一键、enrichment、anchors | db/schema.sql、db/assets.go |
结构迁移 | 资产归一化、跨任务复用 | 没有完整本体推理,语义仍依赖工具/模型 |
| 工作流 DAG/血缘图 | exploration nodes/edges、proves、derived_from |
db/schema.sql、db/exploration.go |
结构 + 问题迁移 | 结论可追溯、分支可视化 | 错误写回仍需校验,边语义非自动真理 |
| 消息队列 | frontier、ClaimIntent、owner |
db/exploration.go、server/engine.go |
控制迁移 | 并发消费、防重复领取 | 需要处理租约、卡死和恢复 |
| 状态机/CAS | open/running/done/blocked/exhausted/paused/stopped | schema.sql、runIntent |
控制迁移 | 暂停、终止、超时语义清晰 | 状态组合多,收尾路径复杂 |
| 事件日志/Trace | activity、Token rollup、tool_use_id |
schema.sql、db/exploration.go |
结构迁移 | 审计、复盘、成本统计 | 外部环境和模型随机性使其不能完全重放 |
| 权限系统/Capability | constraints、Guard、Intercept、traffic | guard/、intercept/、traffic/ |
架构迁移 | 将风险控制放到工具边界 | 规则配置复杂,覆盖范围仍依赖适配器 |
| 缓存/工作集 | graph_overview、cold digest、按需详情 |
agent/tools.go、agent/compaction.go |
特化迁移 | 控制上下文和 Token 成本 | 摘要损失细节,需防过期视图 |
7.9 论文式结论:ARTEX 真正迁移的不是名词,而是责任边界
ARTEX 并没有完整实现某一个经典系统,而是把多个原型拼接成一套面向长任务 Agent 的控制面:黑板提供共享状态,资产图提供可复用实体,探索图提供本次推理血缘,队列和状态机提供并发与恢复,activity 提供审计,Guard/Intercept 提供动作边界,digest 提供上下文工作集。
最深的迁移并不是“把任务画成图”,而是把 LLM 从长期状态的唯一所有者降级为局部决策者:
- 目标和意图由数据库保存,模型不能凭记忆声称已经完成;
- 领取和状态转移由原子更新控制,模型不能凭 Prompt 声称自己独占任务;
- 事实和发现必须挂接资产、节点、工具和证据,模型的自然语言只能提出候选解释;
- 上下文可以压缩和重建,模型会话可以中断和替换,系统仍能从持久化状态恢复。
因此,ARTEX 的核心收益可概括为:把 LLM 的不确定性包在一个可查询、可校验、可暂停、可恢复的系统控制面内。它牺牲了一部分单 Agent 的自由漫游和实现简洁性,换来了长任务中更重要的可追溯性、并发安全和失败可恢复性。这也是“双图 + 黑板 + Worker”组合比单纯增加 Prompt 长度更有工程价值的原因。
8 联想:还可以继续迁移什么
8.1 纵向迁移
- 黑板版本号和乐观并发控制:Planner 读取版本 v 后提交时若已变成 v+1,要求重新确认,减少基于过期态势派发的方向。
- 公平调度与 aging:避免某一类高热意图长期占满 Worker。
- 事件溯源重放:保存每次 graph mutation,模型升级后重建 graph_overview,比较新旧 Planner 决策。
- 事务性计划日志:把 TodoStore 升级为数据库中的 plan/version/step 表,服务重启后精确恢复依赖。
- 失败学习和回退:将 blocked/exhausted 的失败模式结构化,供下一轮选择替代策略。
8.2 横向迁移
- 数据分析 Agent:资产图是表、字段、指标和数据源;探索图是问题、查询、观察、假设和结论。
- 代码维护 Agent:资产图是仓库、模块、依赖和测试;探索图是 issue、假设、补丁、测试结果和回归结论。
- 科研 Agent:资产图是论文、数据集、实验环境;探索图是研究问题、实验意图、结果、反例和证据。
- 企业流程 Agent:资产图是客户、订单和权限对象;探索图是申请、审批、动作和审计事件。
关键不是把漏洞改名为任务,而是保留两种语义:一张图保存可复用对象,另一张图保存本次任务的推导链。
9 使用体验与适用边界
9.1 使用体验
ARTEX 的体验重点不是聊天回复,而是任务状态可见性:任务页显示 Planner/Worker 执行过程,探索图显示目标—意图—事实—发现链路,发现页保留证据入口,活动和 Token 记录解释长任务成本,暂停/取消/超时/复测拥有独立状态。
代价是学习成本:使用者需要理解资产范围、任务目标、意图状态、Worker 预算、LLM 配置和审批规则。它更像面向工程团队的控制台,不是开箱即用的聊天机器人。
9.2 适合场景
- 隔离实验室中的 Planner/Worker、多 Agent 和工具治理研究;
- 自有靶场的合规任务编排和证据留存;
- 双图、黑板、事件日志和长任务 Agent 的系统研究;
- 将这套架构迁移到代码审查、数据分析和科研实验等低风险领域。
9.3 不适合场景
- 一次简单问答或短脚本调用;
- 没有数据库、审计和权限边界,却希望 Agent 自动操作生产系统;
- 需要硬实时、完全确定性或零幻觉保证的控制系统;
- 把公开 Demo、新闻报道或版本指纹当作真实目标授权依据。
10 总结:ARTEX 的真正贡献
ARTEX 不是让一个模型承担整个系统的记忆、调度、证明和安全责任,而是把问题拆成可以分别治理的部分:
1 | 目标是什么? → goal |
它借用的 CS 原型非常清楚:黑板架构提供共享状态,知识图谱提供血缘,工作队列提供并发领取,状态机提供生命周期,事件日志提供复盘,权限与沙箱提供安全边界。LLM 只负责最不确定的部分——从自然语言和当前态势中提出候选方向、选择工具并解释观察。
长任务可靠性不是靠更长的 Prompt 获得的,而是靠让关键状态离开 Prompt,进入可以读取、校验、追踪和恢复的系统结构。
这个工作骨架设计理念非常优秀,包括马上就有二开把呢不能用于做别的工作如AI代码审计:Artex二开-代码审计平台
项目地址:https://github.com/Ernket/CodeScan-Artex
SCA Audit 不是从零写的,它基于 ARTEX 二开(沿用 AGPL-3.0 许可证)。ARTEX 原本是 AI 自主渗透测试方向的平台,而这版二开的方向很明确——保留它的 Agent 编排内核,把能力面整体转向静态审计。
保留的是内核:
- • 双图架构:资产图(系统对外暴露了什么)+ 探索图(结论是怎么一步步推导出来的)
- • 多角色分工:目标拆解 / 规划 / 执行 Agent / 主 Agent / 漏洞复核
- • 事件驱动编排:每次唤醒是全新会话,靠图与待办清单保证跨会话稳定推进
砍掉的部分更关键——平台层面彻底移除攻击性能力:
- • 不出网:不发起任何网络请求,不查外部 CVE 库
- • 不执行命令:没有 Bash,没有脚本执行
- • 不抓包、不回放:没有流量工具
- • 不注入外部 MCP 工具
而且这不是靠提示词「约束」,是在工具装配层物理删除:Agent 的通用工具集只从 7 个本地文件工具(Read / Write / Edit / MultiEdit / LS / Glob / Grep)构造,其余工具在装配最后一步被硬剥离。
一句话:结论必须由源码证据支撑。